安派 Agent 的多层会话压缩设计
安派的会话上下文设计围绕两件事展开:让 Agent 接住连续追问,并在历史压缩之后仍能找回细节。摘要负责保留讨论脉络,原文归档提供核对依据;多层压缩控制输入体积,后台执行减少临时整理历史带来的等待。
1 连续对话需要保留什么
用户回复了一句“可以”,Agent 却忘了刚才在讨论什么。
这是我们在安派里遇到过的实际问题。上一轮,助手还在询问是否帮用户创建提醒;下一轮,它又开始询问用户需要安排什么。对于一个需要持续协作的 Agent,用户期待的连续性,在这里断开了。
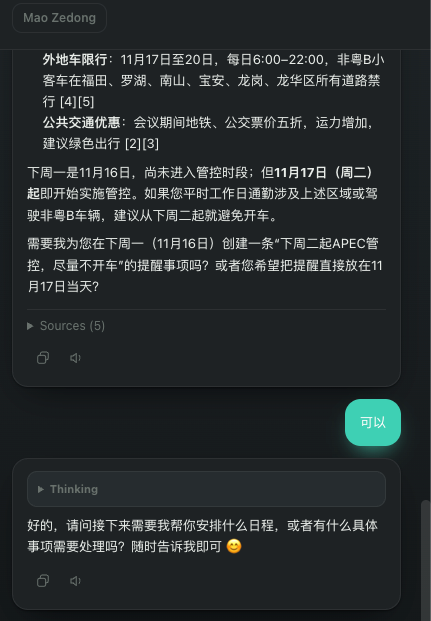
最初的故障来自部分链路没有正确传递历史。这首先需要修复上下文传递:第二轮请求必须带上相关的第一轮问题、回答和工具结果。短对话能接续之后,才有必要验证长会话在压缩后是否仍然连贯。
历史变长后,摘要可以减少每轮输入,但概括会丢失细节。因此,我们同时保留摘要和完整原文:平时使用摘要与近期对话,需要准确措辞、数字或修改过程时,由 Agent 按需回查。
2 主流程 从摘要理解到原文回查
从上到下按箭头编号阅读。用户追问进入 Core 后,Agent 在调用模型前取得装配好的上下文。框内是按需回查:通过工具读回原文,补入上下文,再次调用模型。历史压缩的生成过程放在后文说明。
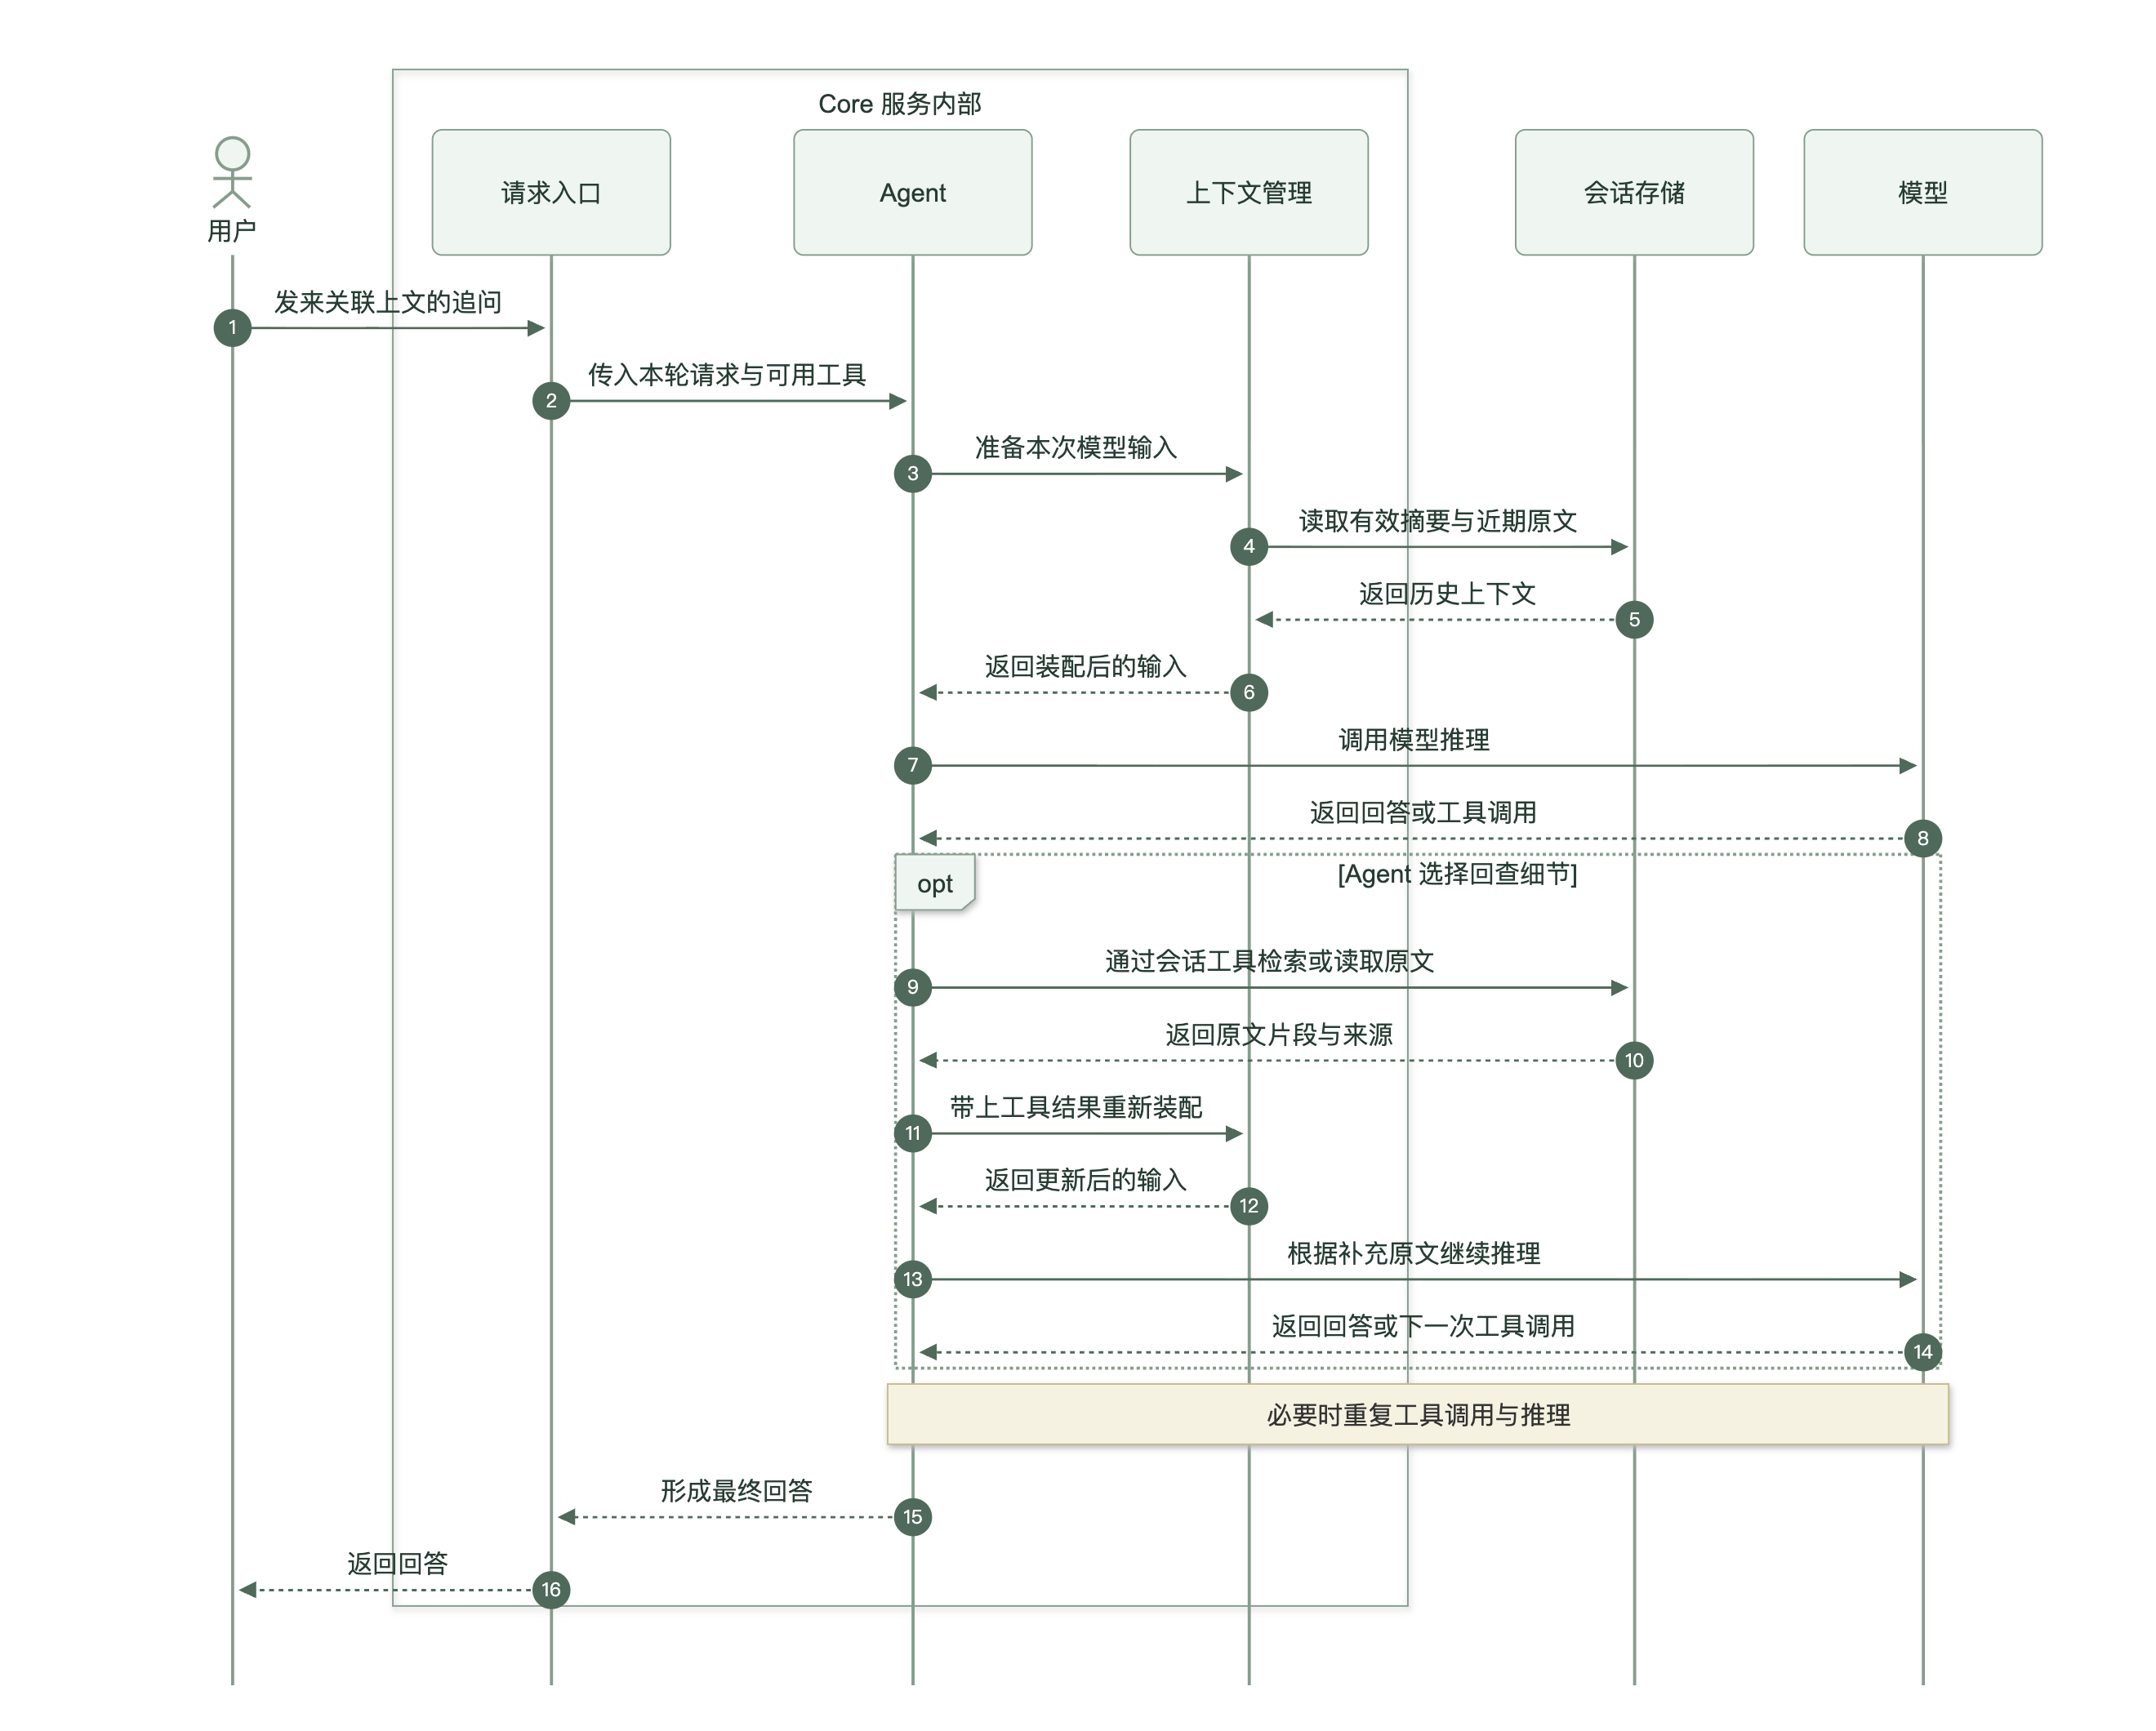
Core 准备身份权限、时间快照、系统指令和可用工具。上下文管理器在每次模型调用前读取有效摘要和近期原文,加入当前问题与工具结果,并检查容量。图中的会话存储合并表示原文、摘要与检查点;Agent 通过受权限和版本校验的会话工具回查,不直接访问数据库。
例如,摘要记得“预算已经调整”,但用户追问“我当时改成多少,原话是什么”。Agent 可以利用摘要中的引用读取原消息,把具体数字和措辞补回当前上下文,再继续回答。这个例子说明回查机制,不代表每次都能自动识别缺失信息。
3 多层摘要怎样控制历史体积
| 层次 | 保存什么 | 什么时候使用 |
|---|---|---|
| 原文归档 | 消息、附件提取文字、真实工具回执 | 精确引用、核对事实和重建上下文 |
| 近期原文 | 最近完整交互与尚未结束的交互 | 理解“可以”“第二个”等连续追问 |
| 分段摘要 | 较早交互的目标、约束、修改与未决事项 | 延续已经讨论过的工作 |
| 父摘要 | 多个摘要覆盖的更长历史 | 分段摘要本身也开始占用过多空间时 |
下面用一组示意节点说明装配方式:P 已经概括 A 和 B,本轮只发送 P、后来生成的 C,以及尚未压缩的近期原文。
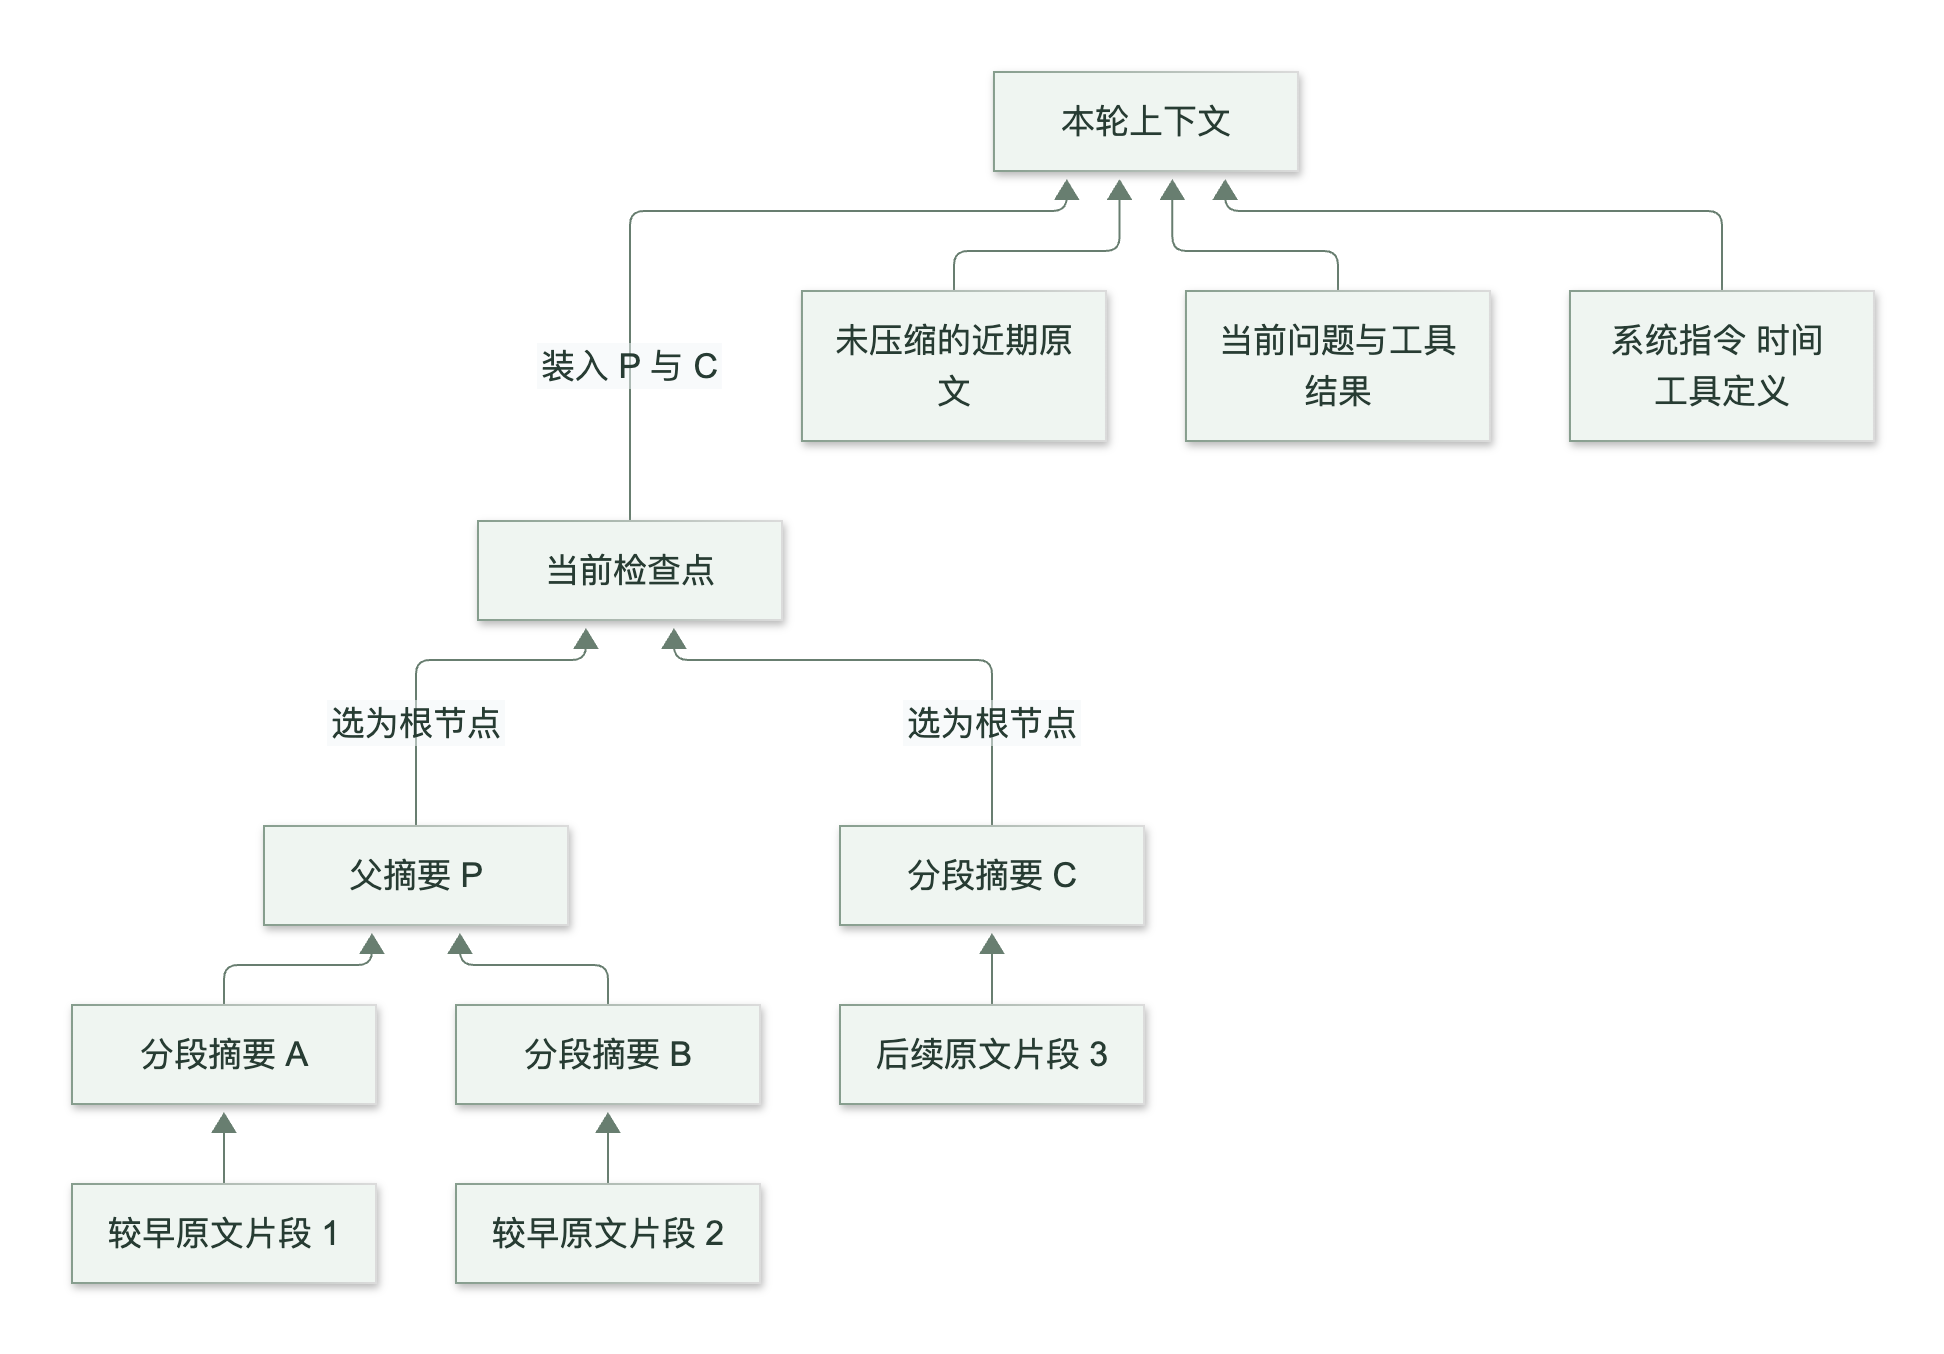
父、子节点都会保存在数据库中,但本轮不会重复装入 P 和它覆盖的 A、B。多个有效根节点可以同时存在,无须先把整个历史合成一段总摘要。
摘要节点保存正文 body、原始来源清单 source_manifest 和子节点 child_ids。父摘要继续继承原始引用;合并只有在完整输入确实缩小时才生效。
检查点记录当前根节点 root_ids、覆盖位置 cutoff 和原文版本。装配时先读取有效根,再补上覆盖位置之后的历史。这让新增内容能够逐步压缩,已完成的部分持续复用。
4 摘要如何生成 存储与复用
会话压缩由 Core 的容量策略触发:历史追加、重新打开会话时评估历史体积,上下文管理器也会在实际输入接近容量边界时请求后台整理。Agent 不需要决定是否压缩。摘要正文由后台任务单独调用模型生成;服务端负责选择完整交互、校验来源、保存节点和发布检查点。
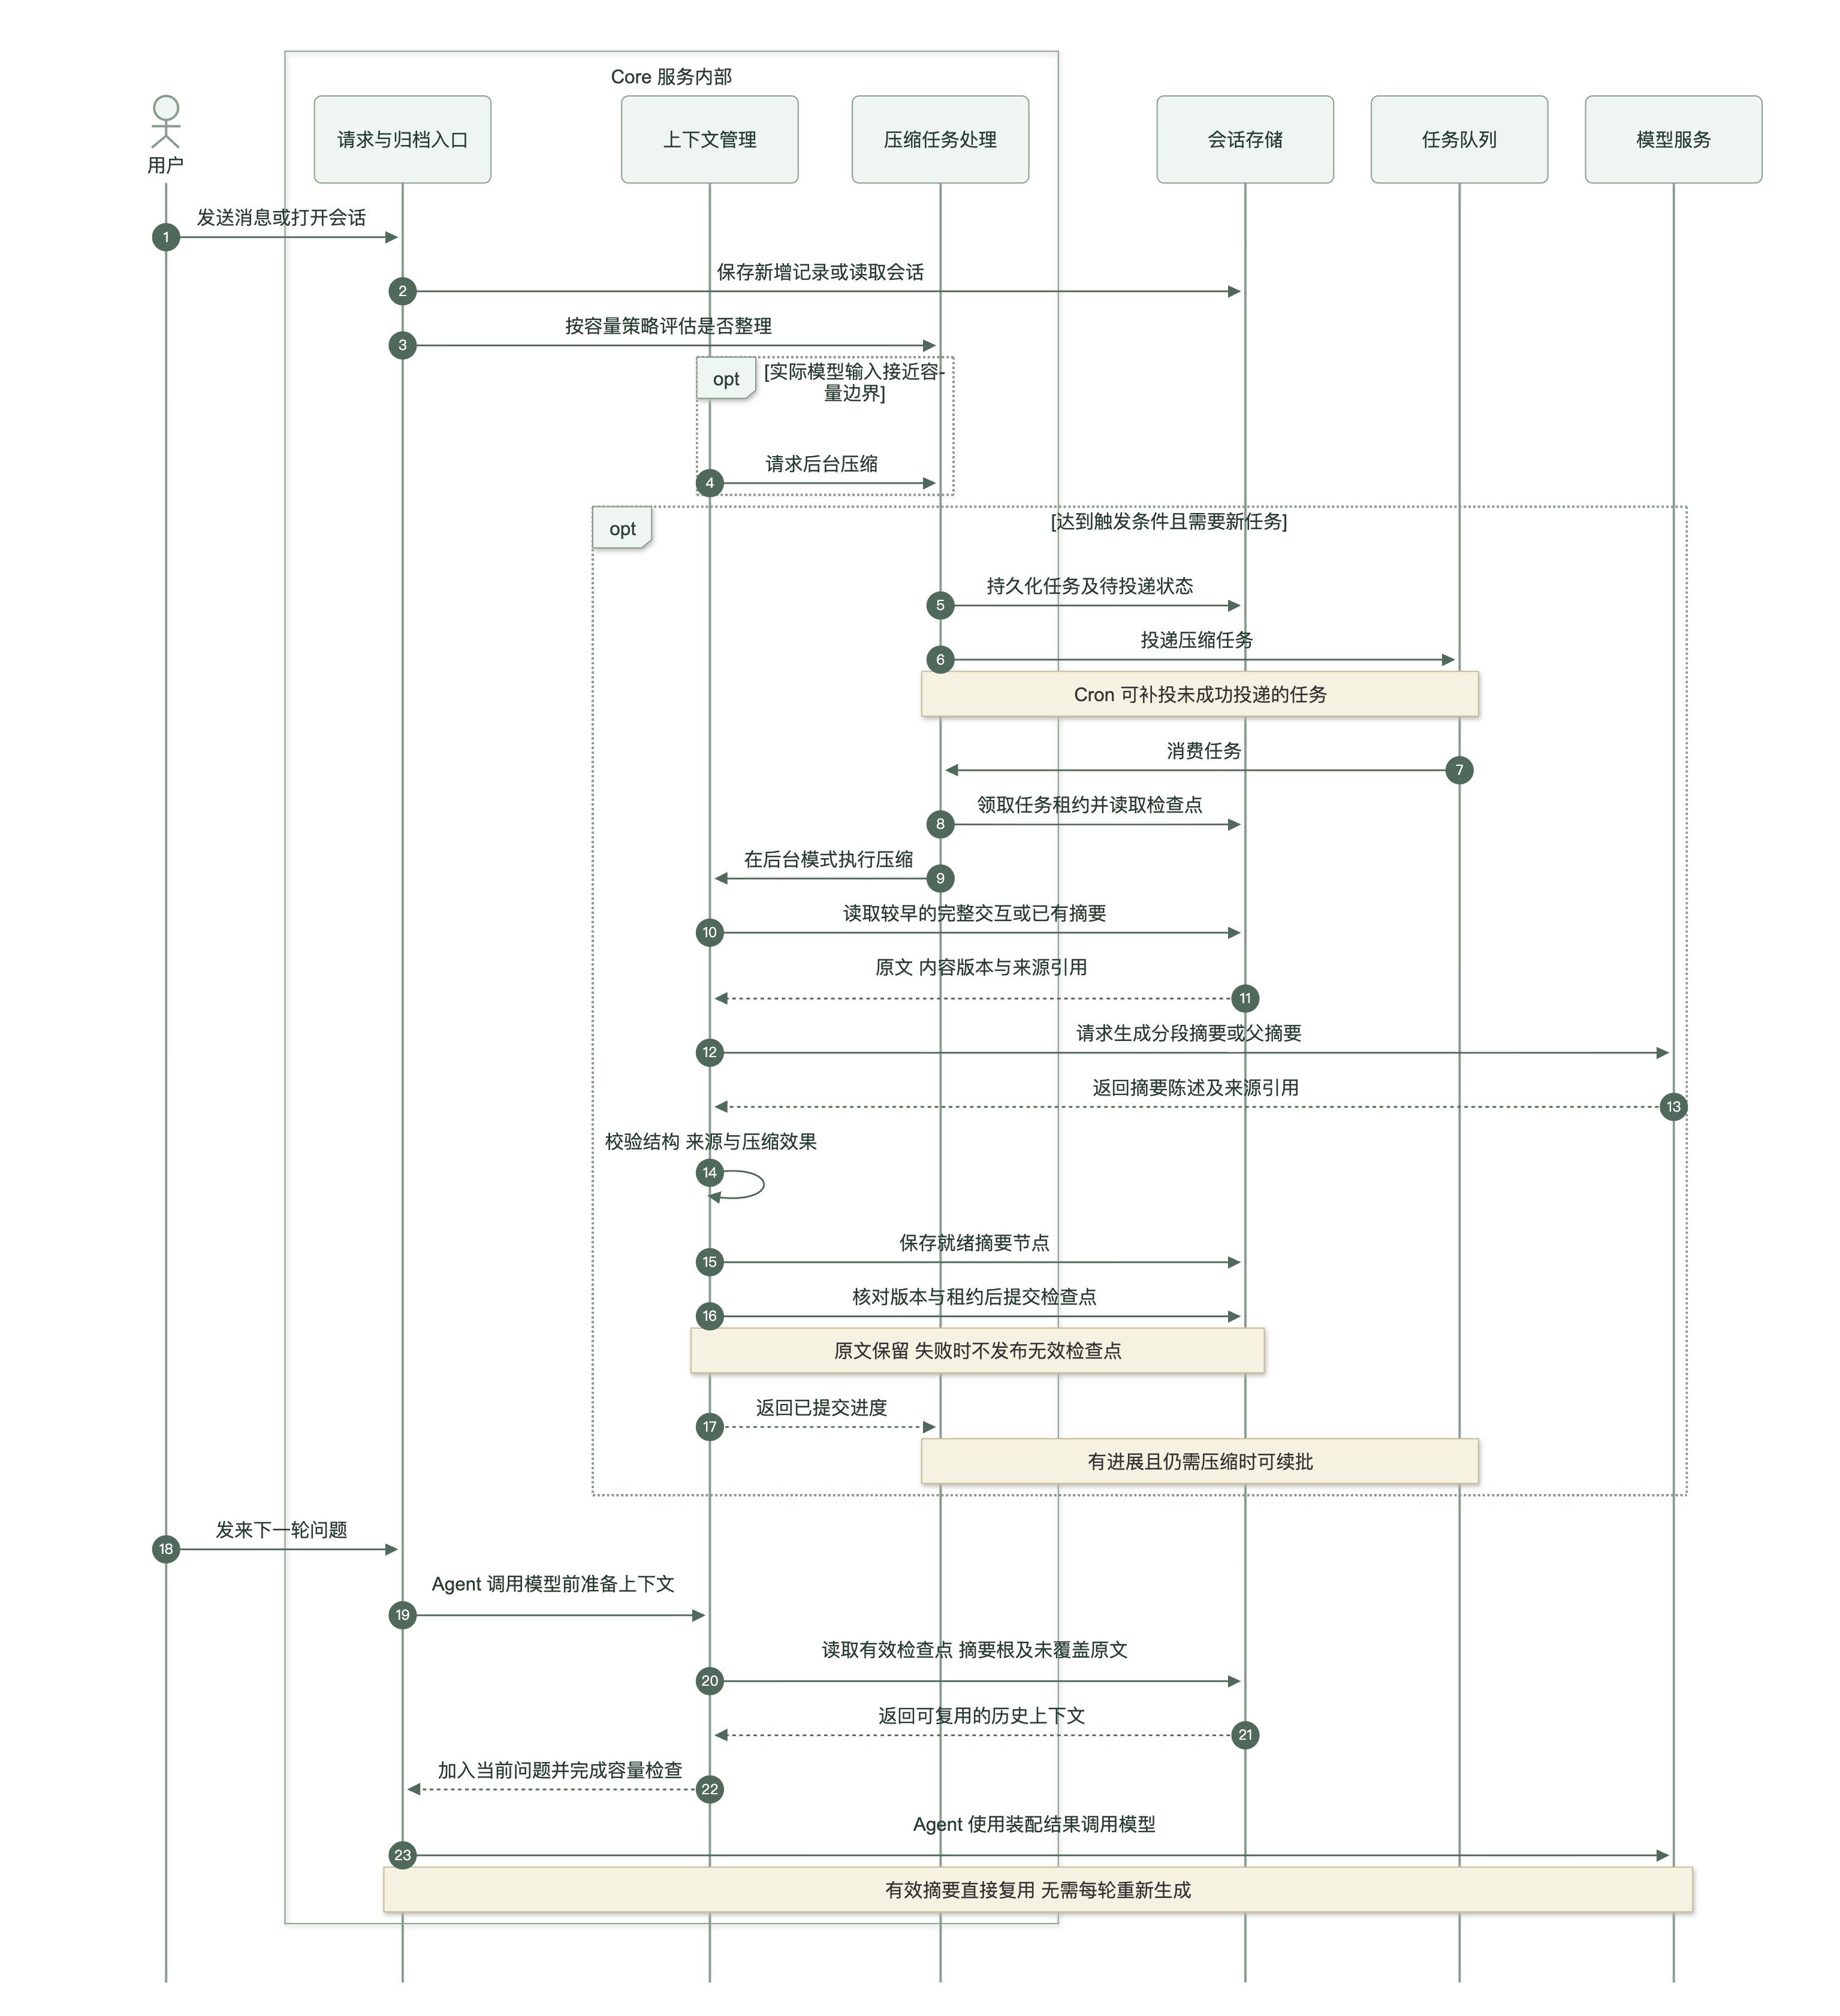
图中的“压缩任务处理”合并表示 ConversationCompactionJobs 和 ConversationCompactionService;它们属于 Core 的代码,由队列事件驱动后台执行,并非需要用户保持页面打开。后台上下文管理器组织摘要输入,模型生成正文,ConversationSummaryStore 保存节点并提交检查点。图中入口代指前台请求路径,实际模型调用仍由 Agent 驱动。
提交时核对原文版本、任务租约、节点就绪状态和预期检查点版本,防止较慢的旧任务覆盖更新结果。前台读取的是已经发布的检查点。
后台仍受调用预算、超时和重试限制。如果输入超过硬上限,前台可能有界等待;最终无法容纳时明确失败,原文继续保留。
5 原文回查怎样保证可追溯
摘要承担概括职责,精确内容由原文提供。Agent 可以调用 search_conversation 定位当前会话记录,再用 read_conversation 按带版本的引用读取;已有引用可以直接读取,长记录分页续读。
当前检索支持字面匹配、说话者筛选和按时间浏览。没有命中某个词,只说明这次查询未找到结果。这条回查路径独立于公网搜索开关。
我们还保留来源归属和核验状态。用户陈述、助手答复与工具回执分别记录;摘要陈述统一标记为 unverified_summary。例如,“助手说没有找到记录”不能在压缩后升级为“确认不存在记录”。
来源引用能证明出处存在,但不能保证概括完全准确。遇到冲突、精确措辞或关键执行状态,Agent 仍需要读取原文。权限、版本与分页由服务端校验,是否回查及如何理解由 Agent 决定。
6 会话压缩与长期记忆有什么区别
| 维度 | 会话压缩 | 长期记忆 |
|---|---|---|
| 范围 | 当前会话 | 当前用户的跨会话信息 |
| 主要内容 | 目标、约束、修改、进度 | 明确保存的事件、经历、偏好与关系 |
| 进入推理的方式 | 按检查点装配摘要和近期原文 | Agent 通过记忆工具按需查询 |
| 存储 | 原文、摘要节点、检查点 | memory_items 与 memory_sources |
| 更新方式 | 历史增长后生成和合并摘要 | 独立保存、纠正与删除 |
普通 Agent 链路通过 search_memory、remember_memory、correct_memory 和 forget_memory 访问 MemoryService。查询按用户隔离,对有效确认条目做关键词和时间等条件过滤;纠正保留替代关系,删除采用软删除。这里的确认状态表示条目已保存,不代表事实经过外部核实。
“这篇文章简短一点”约束当前任务;“以后技术文章都尽量简洁”表达跨任务偏好。两者都需要被本轮理解,但长期保存需要独立操作。摘要层级只表示压缩程度与覆盖范围,摘要节点不会自动写入长期记忆库。
7 当前边界
这套设计仍在隔离预发完善。验证顺序是:先确认短对话的上下文完整传入,再确认压缩后的状态能够延续、细节能够回查,最后检查后台执行是否减少等待。已有摘要复用和原文读取已有实际链路支撑,但较大的工具结果仍可能挤占后续推理空间;读到原文也不等于整轮回答必然完成。
评论