从 Promise.all 到 LangGraph,拆解春风 AI 的一轮多 Agent 复盘
「帮我复盘本周。」效率大师和目标教练都交了意见,反思导师调用模型超时。这时,页面能先显示谁的结果?春风要等到什么时候才能汇总?如果用户关掉页面再回来问「下周先做什么」,它从哪里找回刚才那份周报?
这几个问题发生在同一条对话里,靠的是不同层次的机制。我们在安排日历的复盘中心,用一组虚构资料把它们拆开验证。后面的例子都用这四条资料。编号是服务端给模型和程序用的,用户界面展示「纸船项目草图」这样的标题。
| 编号 | 所选周的资料 |
|---|---|
E01 |
纸船项目草图,已完成 |
E02 |
样机验收,已过期未完成 |
E03 |
周末散步,已完成 |
G01 |
年度目标「纸船项目」 |
1. 旧版已经会并行,问题出在怎么交接
早期周报是一个生成任务。服务端查出启用的导师,给他们同一份日程、目标和画像,各自的系统提示词不同。agents.map(async …) 发起模型请求,Promise.all 等各路结束。每路各自捕获错误,成功的意见一到就保存,顺便通过 SSE 更新对应的界面。最后一次模型调用负责综合。那时周报和各路分析分 Tab 展示,追问框只会返回占位文本。
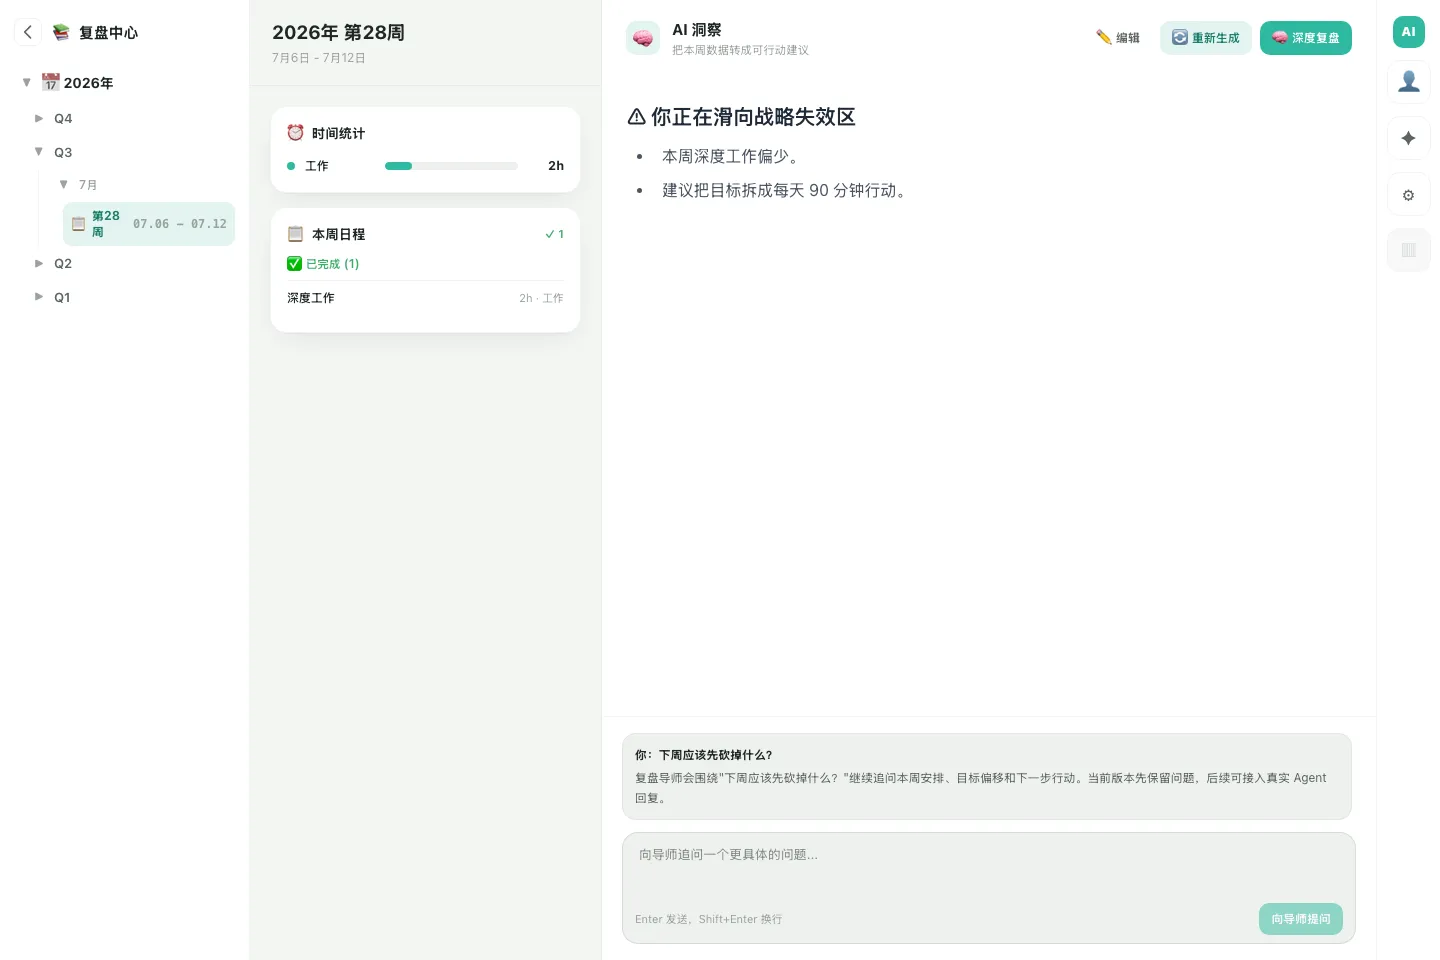
旧版界面测试使用模拟数据。放大右下角可以看到当时的占位回复。
有段旧代码把两种顺序混在了一起。导师名册是 [效率, 目标, 反思]。各路完成后调用 insights.push(saved)。假设目标教练先回来,效率大师后回来,反思失败,结果数组就成了 [目标意见, 效率意见]。汇总又拿 agents[idx]?.name 拼标题,第一条意见就可能写成「效率大师」。这是从旧实现推导出的风险。
Promise.all 自己返回的数组仍保持传入顺序,错位发生在回调往外部数组追加这一层。让每路返回 { advisorId, opinion } 或 { advisorId, failure },再按 ID 关联,保留原先的并发方式也能解决。这个修法很重要,因为后面用 LangGraph,交接仍然依靠同一个 ID。
新的需求发生在生成报告之外。用户有时要整周复盘,有时只要统计数字,有时是接着报告问下周行动。一次复盘产生的意见只属于当轮,但报告和问答要留给下一轮。我们开始用图明确这轮走哪个步骤、每个步骤能读写什么,以及运行到哪里可以认为完成。
2. 从一条边开始理解 State
先只看「取资料,再给回答」。我们可以把它拆成 retrieveContext 和 respond 两个函数。addNode 注册函数,addEdge 定义前一个结束后调度哪一个。START 和 END 是入口与终点。建好节点和边后,compile() 得到可执行的图。收到用户请求时调用 invoke(input, config),这时节点才开始运行。图中有普通代码,也有模型调用。比如 retrieveContext 读数据库服务和整理资料,analyzeAdvisor 才负责调用导师模型。
StateSchema 声明运行过程中会用到的字段、类型和默认值。以刚才的问题为例,输入只需要问题和周范围。读取资料的节点把数据写到 facts,回答节点从自己的输入读 facts,再返回 synthesis。下面是连续两步的状态变化,省略了真实图的其他字段。
初始输入      { question: "帮我复盘本周" }
读取资料返回  { facts: [E01, E02, E03, G01] }
读取后的状态  { question: "帮我复盘本周", facts: [...] }
回答节点返回  { synthesis: "本周先核对样机验收" }
最终状态 { question: "...", facts: [...], synthesis: "..." }这里最容易误解的是节点的返回值。{ facts } 是对状态的一次更新,所以没提到的 question 还在。节点把要更新的字段交给图处理。对单写入者的普通字段,本次更新替换该字段的旧值。遇到并行节点同时更新一个字段时,图需要知道该怎样处理这两份值,这就是后面要加 Reducer 的地方。 LangGraph 的 State 和 Reducer
生产图另外声明了 TurnInput 和 AdvisorInput。前者只接收问题、回合 ID、语言和周范围,后者只接收一位导师和分给他的资料。完整的 ReviewState 还保有路由、各导师结果、总结和历史回合。把三个 schema 分开,等于把调用者能提交什么、内部要跟踪什么、导师能拿到什么分别定下来。
3. 先决定要不要叫导师,再加载资料
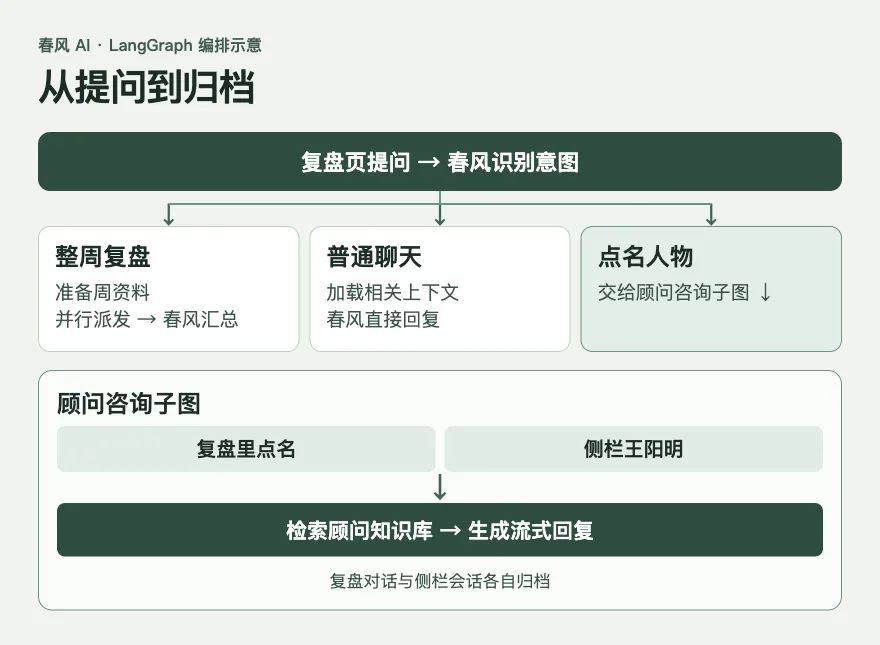
只有一条固定边时,「帮我复盘本周」和「这周完成了几项」都会进入同一段逻辑。春风在前面加了 routeQuestion。它看本轮问题、最近三轮对话摘录、当前周和可用导师,用 withStructuredOutput 得到结构化意图。模型给出 { kind: 'delegate' } 表示请求整周复盘,程序校验这个结果,再从当前名册补上三个导师 ID。模型输出和工作流实际使用的路由因此是两份数据。
用户问题    帮我复盘本周
模型意图    { kind: "delegate" }
应用路由    { kind: "delegate", advisorIds: [efficiency, goal, reflection] }
下一节点    retrieveContext
addConditionalEdges 在 routeQuestion 之后读取刚写出的 route,据此选择下一站。整周复盘先进 retrieveContext,资料齐备才派发任务。统计走确定性的计数逻辑。闲聊进入 retrieveChatContext 后由春风回复。路由需要的前置资料很少,和答复时真正要读的日程、目标、画像及相关记忆分开准备。我们仍然在取资料的函数里用 Promise.all 并行查画像和相关记忆,两路的结果组成一份 facts,再交给图。 LangGraph 的条件边
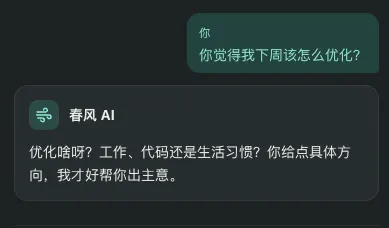
这次改动有一个具体起因。早期我们直接问「你觉得我下周该怎么优化」,春风回了一句「工作、代码还是生活习惯?」在复盘页问这句话时,所选周、年度目标和先前周报已经能给它更多线索。我们让普通聊天也准备相关上下文,同时保留少量历史摘要。整周分析仍是另一条路,只有它会派发一组导师。
4. Send 分派输入,Reducer 汇合产物
走到 retrieveContext,图里已经有一份全周事实。接下来要运行三次同一个 analyzeAdvisor 节点。每次的任务不同,参与人数也取决于当前名册。在这组合成数据里,效率大师看有具体起止时间的 E01 和 E02。目标教练看与项目、学习相关的记录以及 G01。反思导师只收到未完成的 E02。两位导师可能都看同一条事实,范围由各自任务决定。
下面是生产逻辑的缩写。回调返回三份 Send,每份包含一个目标节点名和这一次调用的输入。addEdge 负责固定顺序,Send 则在运行时决定同一节点要创建几个任务。
.addConditionalEdges('retrieveContext', ({ route, facts }) => {
  if (route.kind !== 'delegate') return 'respond';
  return assigned(route).map(advisor =>
    new Send('analyzeAdvisor', {
      advisor,
      facts: advisorContext(facts, advisor),
    }),
  );
}, ['analyzeAdvisor', 'respond'])
.addEdge('analyzeAdvisor', 'synthesize')
4.1 先看同一步里能读到什么
LangGraph 把可执行的任务按一轮一轮调度,文档称为 super-step。在这张图里,三份 Send 会让三个任务进入同一个 super-step。目标教练先结束时,另一个导师的输入仍是派发时的那份资料,它读不到目标教练同一步返回的意见。等这一步的任务都得到结果,下一步的 synthesize 才读到合并后的状态。对于不同长度的并行路径,汇合还要看具体边怎么连接。这里的三个任务来自同一次派发,目标是同一个节点。 LangGraph 的 super-step 与 Send
4.2 再看三份写入怎么合在一起
假设这一次三位导师都成功。每位只返回自己的意见项,图对 opinions 这个字段应用同一条合并规则。
初始 opinions            {}
效率的更新               { efficiency: "先为验收留时间" }
目标的更新               { goal: "核对纸船项目下一步" }
反思的更新               { reflection: "确认验收卡点" }
下一步读取               { efficiency: …, goal: …, reflection: … }
普通字段支持在一步中接收一次更新。我们在早期实验里让两路同时写入一个普通字段,图报了并发更新错误。生产用 ReducedValue 给 opinions 和 advisorFailures 分别定义合并方法。每来一份更新,Reducer 接收当前累积值 previous 和这一份 update,返回 { ...previous, ...update }。不同 ID 会同时保留,同一 ID 会被新值覆盖。名册在入口校验 ID 唯一,所以一轮不会给同一个 ID 派两份分析任务。汇总时按这轮选择的 ID 逐项读回,导师姓名和完成顺序无关。 LangGraph 的并发状态更新
5. 反思导师超时,另外两份为什么还能汇总
导师交给下游的是结构化观察和行动。以反思导师为例,它拿到 E02,那么「核对样机验收卡在什么地方」可以引用 E02。如果模型又生成一条依赖 E03 的意见,由于这条记录未分给它,程序就过滤这条意见。同一份结果里其他引用有效的观察还可以保留。只有留下足够的有效内容,才会进入结果映射。引用 ID 通过校验意味着能追溯到本轮资料,观点是否得到充分支持还要看原始记录。
接下来让反思导师第一次超时。retryPolicy 只接受被适配器归为临时故障的异常,maxAttempts: 2 包含第一次调用。因为每个 Send 对应独立任务,这条策略只会重跑反思导师。效率大师和目标教练各跑一次,它们的结果仍可参与下一步。
第二次如果又遇到已识别的临时故障,节点把它转换为 advisorFailures 中以 reflection 为键的一条记录。已判定的无效模型输出也直接写为失败。这样,三项任务都有了明确结果,synthesize 可以用两份有效意见生成报告并注明「2/3 位导师」。如果三份都失败,汇总直接返回失败状态。未知异常与取消则继续向外传递,按整轮中断处理。失败后能否继续是应用选择,重试上限本身只规定尝试次数。 LangGraph 的节点重试
独立测试有意让先到的导师停在同一个等待点,直到第三位也进入才统一放行。若调用实际上是串行的,这个用例会超时。然后让反思导师失败,记录三位的尝试次数为 1、1、2。复测一次重试恢复,再测一次耗尽,汇总分别得到三份和两份意见。这样能验证调度和降级行为,报告质量仍要另外评测。
6. 页面收到导师结果,和这轮已经保存,是两个时点
如果目标教练先完成,analyzeAdvisor 可以马上发 agent_insight 更新它的卡片。运行时同时还在等反思导师的任务结果。卡片收到事件、节点写回状态、下一步开始汇总,发生在三个不同的时点。生产通过 streamMode: 'custom' 接收自定义事件,再由 HTTP 接口转成 SSE。 LangGraph 的自定义流事件
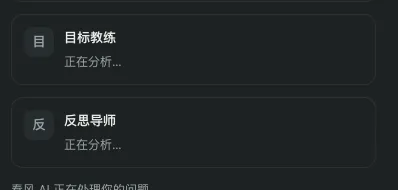
早期界面把每位导师的进度放在自己的卡片里。
流式内容也有两种写法。reply_delta 是新增文本,前端追加到已有文字。agent_preview 和 reply_preview 是当前可展示的结构化快照,前端用它替换旧预览。把快照当增量拼接,会把同一条观察显示多次。第二次尝试开始时,导师节点还会发送空的预览来清理第一次尝试留下的内容。
春风汇总完成后,recordTurn 将问题、最终回复、导师状态和引用写进 turns。服务端随后读回图状态,确认本轮 turnId 确实已经保存,再发 turn_done。前端就能区分「看到了几段正文」和「这一轮已完整归档」。我们在顾问侧栏也遇到过类似竞态。原来服务端先发完成,再写归档,客户端收到完成立即断开时可能读不到这轮。将完成事件移到归档尝试之后,才覆盖了那个断连场景。周复盘接口另有回合读回检查。
7. 同一个问题再发送一次,到底会发生什么
用户刷新回来,发一个新问题「下周先做什么?」。生产把用户和所选周映射成同一个 thread_id。编译图时注入的 Checkpointer 会按这个键加载前一次图状态。第一轮已经保存的 turns 因此还在,春风可以读到纸船项目的周报。生产使用 PostgreSQL,示例使用进程内的 MemorySaver。后者能在一次演示里续聊,关闭进程后数据随之消失。 LangGraph 的检查点
第二轮照常从 prepareTurn 开始。第一轮 opinions 里有两位导师的结果。给 Reducer 一个 {},计算的是 { ...旧意见, ...{} },结果还是原来两位。生产用 new Overwrite({}) 跳过合并来清空意见和失败映射,同时保留 turns。路由把这轮识别为追问,respond 能从旧回合挑出周报,把摘要交给本轮模型。两份旧意见仍可在历史里展开,而本轮没有任何导师任务。 LangGraph 的 Overwrite
这里有两个 ID。thread_id 定位「哪一个会话」,turnId 定位「哪一次用户提交」。新问题用同一线程、不同回合 ID,运行一轮新图。网络断开后,前端用原 turnId 重发相同问题,服务端先查该回合是否已完成。查到了就读回原答复,省去重复模型调用和额度消耗。同一回合 ID 换成不同问题会返回冲突。生产还用按线程的 PostgreSQL 租约协调并发提交。前一次若尚未写成完整回合,重发仍可能重新执行。
7.1 接着点名王阳明,为什么要另有一张小图
同一条对话里,用户接着问「请王阳明用知行合一分析我的样机验收」。主图识别出明确的顾问和主题,通过 consultAdvisor 调用 retrieve → respond 两节点子图。检索端收到的是顾问 ID 和受控主题「知行合一」。这轮日程里匹配到的「样机验收」和同顾问的历史,只作为生成节点的输入。两个节点各拿自己需要的数据。
当用户再问「能举个小例子吗」,主图从上轮的 speaker 和咨询状态识别出活跃顾问,沿用其身份。如果用户改回请春风答复,路由会按新指令分流。复盘与侧栏可复用同一个顾问子图,归档各自维护。年度目标和短期对话来自账号上下文,著作引用来自顾问知识库,两个来源在图里各有入口。 LangGraph 的子图
8. 一段可运行的缩小版
这段示例用同一组纸船资料,跑两轮同线程对话。第一轮反思导师重试后仍失败,保留两份意见。第二轮清空临时意见并读回上轮总结。模型用确定的函数模拟,意图也只保留复盘与追问两种。真实路由的结构化输出、引用校验和 RAG 在上面的生产流程里。
保存为 review-demo.mts,在空目录安装 @langchain/langgraph@1.7.1、@langchain/core@1.3.5 和 zod@4.6.7,用 Node.js 24 执行 node review-demo.mts。
import {
  END, MemorySaver, Overwrite, ReducedValue, Send,
  START, StateGraph, StateSchema,
} from '@langchain/langgraph';
import * as z from 'zod';

const Advisor = z.enum(['efficiency', 'goal', 'reflection']);
const Fact = z.object({ id: z.string(), title: z.string() });
const Assignment = new StateSchema({
  advisor: Advisor,
  facts: z.array(Fact),
});
const turnFields = { turnId: z.string(), question: z.string() };
const byId = () => new ReducedValue(
  z.record(z.string(), z.string()).default(() => ({})),
  { reducer: (previous, update) => ({ ...previous, ...update }) },
);
const State = new StateSchema({
  ...turnFields,
  route: z.enum(['delegate', 'chat']).default('chat'),
  facts: z.array(Fact).default([]),
  opinions: byId(),
  advisorFailures: byId(),
  synthesis: z.string().default(''),
  turns: z.array(z.object({ id: z.string(), answer: z.string() })).default([]),
});

const advisors = Advisor.options;
const scope = {
  efficiency: ['E01', 'E02'],
  goal: ['E01', 'E02', 'G01'],
  reflection: ['E02'],
};
const attempts: string[] = [];
class TemporaryModelError extends Error {}

const graph = new StateGraph(State, { input: new StateSchema(turnFields) })
  .addNode('prepareTurn', () => ({
    opinions: new Overwrite({}),
    advisorFailures: new Overwrite({}),
    synthesis: '',
  }))
  .addNode('routeQuestion', ({ question }) => ({
    route: question === '帮我复盘本周' ? 'delegate' as const : 'chat' as const,
  }))
  .addNode('retrieveContext', () => ({
    facts: [
      { id: 'E01', title: '纸船项目草图' },
      { id: 'E02', title: '样机验收' },
      { id: 'E03', title: '周末散步' },
      { id: 'G01', title: '纸船项目' },
    ],
  }))
  .addNode('analyzeAdvisor', ({ advisor, facts }, runtime) => {
    const attempt = runtime.executionInfo?.nodeAttempt ?? 1;
    attempts.push(advisor);
    if (advisor === 'reflection') {
      if (attempt === 1) throw new TemporaryModelError('模拟超时');
      return { advisorFailures: { [advisor]: '暂时不可用' } };
    }
    return { opinions: { [advisor]: facts.map(fact => fact.title).join('、') } };
  }, {
    input: Assignment,
    retryPolicy: {
      maxAttempts: 2,
      retryOn: error => error instanceof TemporaryModelError,
    },
  })
  .addNode('synthesize', ({ opinions, advisorFailures }) => ({
    synthesis: `${Object.keys(opinions).length}/3 位有效。缺席 ${Object.keys(advisorFailures).join('、')}`,
  }))
  .addNode('respond', ({ turns, opinions }) => ({
    synthesis: `本轮意见 ${Object.keys(opinions).length} 份。上轮:${turns.at(-1)?.answer}`,
  }))
  .addNode('recordTurn', ({ turnId, synthesis, turns }) => ({
    turns: [...turns, { id: turnId, answer: synthesis }],
  }))
  .addEdge(START, 'prepareTurn')
  .addEdge('prepareTurn', 'routeQuestion')
  .addConditionalEdges('routeQuestion',
    ({ route }) => route === 'delegate' ? 'retrieveContext' : 'respond',
    ['retrieveContext', 'respond'],
  )
  .addConditionalEdges('retrieveContext', ({ facts }) =>
    advisors.map(advisor => new Send('analyzeAdvisor', {
      advisor,
      facts: facts.filter(fact => scope[advisor].includes(fact.id)),
    })),
    ['analyzeAdvisor'],
  )
  .addEdge('analyzeAdvisor', 'synthesize')
  .addEdge('synthesize', 'recordTurn')
  .addEdge('respond', 'recordTurn')
  .addEdge('recordTurn', END)
  .compile({ checkpointer: new MemorySaver() });

const config = { configurable: { thread_id: 'paperboat-week' } };
const review = await graph.invoke({ turnId: '1', question: '帮我复盘本周' }, config);
const next = await graph.invoke({ turnId: '2', question: '下周先做什么?' }, config);
console.log(attempts.sort().join(', '));
console.log(review.synthesis);
console.log(next.synthesis);
输出里的导师调用是 efficiency, goal, reflection, reflection。第一轮是 2/3 位有效。缺席 reflection,第二轮显示本轮意见为零,同时能读回第一轮的这句话。排序用于让日志容易核对,实际任务完成的先后可以变化。
9. 当流程开始写日历,恢复要多管一层
我们早期做过一个排期实验。前面仍是复盘和取资料,只是多查一次空闲时段,再把两项行动排到下周。addEdge(['review', 'availability'], 'plan') 等两个前置都完成。计划出来后,choose 用 interrupt() 等人确认。调用方拿原线程发 new Command({ resume: decision }),choose 从函数开头重新执行,走到 interrupt() 时取到决定。改时间会返回 Command({ update, goto: 'plan' }),确认则走 commit。节点配置里的 ends 声明可能跳到哪些节点,本次走哪条路由 goto 决定。若再加一条从 choose 到 commit 的固定边,两种调度都可能生效,所以实验只保留 Command 跳转。 LangGraph 的暂停与恢复 · LangGraph 的 Command
还有一个更具体的实验。第一项日程已经写进独立账本,第二项写入前失败,图的检查点仍指向 commit。我们关闭进程,再打开同一个 SQLite 检查点,用 graph.invoke(null, config) 重进 commit。第一项用 taskId:actionId 查到原回执,第二项这次正常创建。账本最终只有两条。检查点知道从哪个节点继续,业务账本知道哪次写入已经生效。两者分别解决恢复和防重。 LangGraph 继续未完成工作
在并行步骤里,Checkpointer 可以记录同一步中已成功任务的状态更新,等恢复时复用。排期实验的两次写入却都发生在同一个 commit 节点内部,第一笔外部写入成功时,节点还没有返回任何更新。这个空档由业务幂等键保护。线上周复盘的断线重发则先查已完成的 turnId,走的是另一条入口。要判断「它还会不会跑第二次」,先看触发的是新回合、节点重试、等待人回答,还是对已有回合的读回,再看外部动作有没有自己的幂等键。 LangGraph 的任务写入与检查点
上线验收时,这种区分也有用。第一次候选能登录、能读旧周报,却在真实人物咨询进入图前因模型配置缺失而失败。补齐配置后,我们才实际跑过从复盘点名、刷新读回引用,到侧栏继续追问的链路。至于三位导师比春风单独回答多提供了什么、花多少时间,还需要用同一批任务分别运行,对照引用、行动建议和耗时。
评论