安派接入 DeepSeek 工具 API 的架构与实现
安派接入 DeepSeek 的 Search、Fetch、OCR、ASR 和 TTS 后,我们调整了三处架构:搜索进入 Agent 工具循环,OCR 原文进入会话归档,所有回答分支共享历史与时间上下文。下面按实际调用链展开,代码中的错误处理和业务字段按需省略。
1 接入位置与接口分工
我们采用独立工具接口,由 Core 持有密钥并调用。推理模型继续走原来的 Agent 链路。DeepSeek 也提供在模型请求内启用工具的接法,官方会处理调用衔接;安派需要把搜索和日历工具放进同一个循环,因此选择自己编排。官方接入方式
| 能力 | Core 调用的接口 | 在安派中的位置 |
|---|---|---|
| 搜索 | POST /v1/tools/search | Agent 工具 web_search |
| 网页阅读 | POST /v1/tools/fetch | Agent 工具 read_webpage |
| OCR | POST /v1/tools/ocr | 附件进入推理前提取文本 |
| ASR | POST /v1/tools/asr | 转写后回填输入框 |
| TTS | POST /v1/tools/tts | 最终回答的朗读输出 |
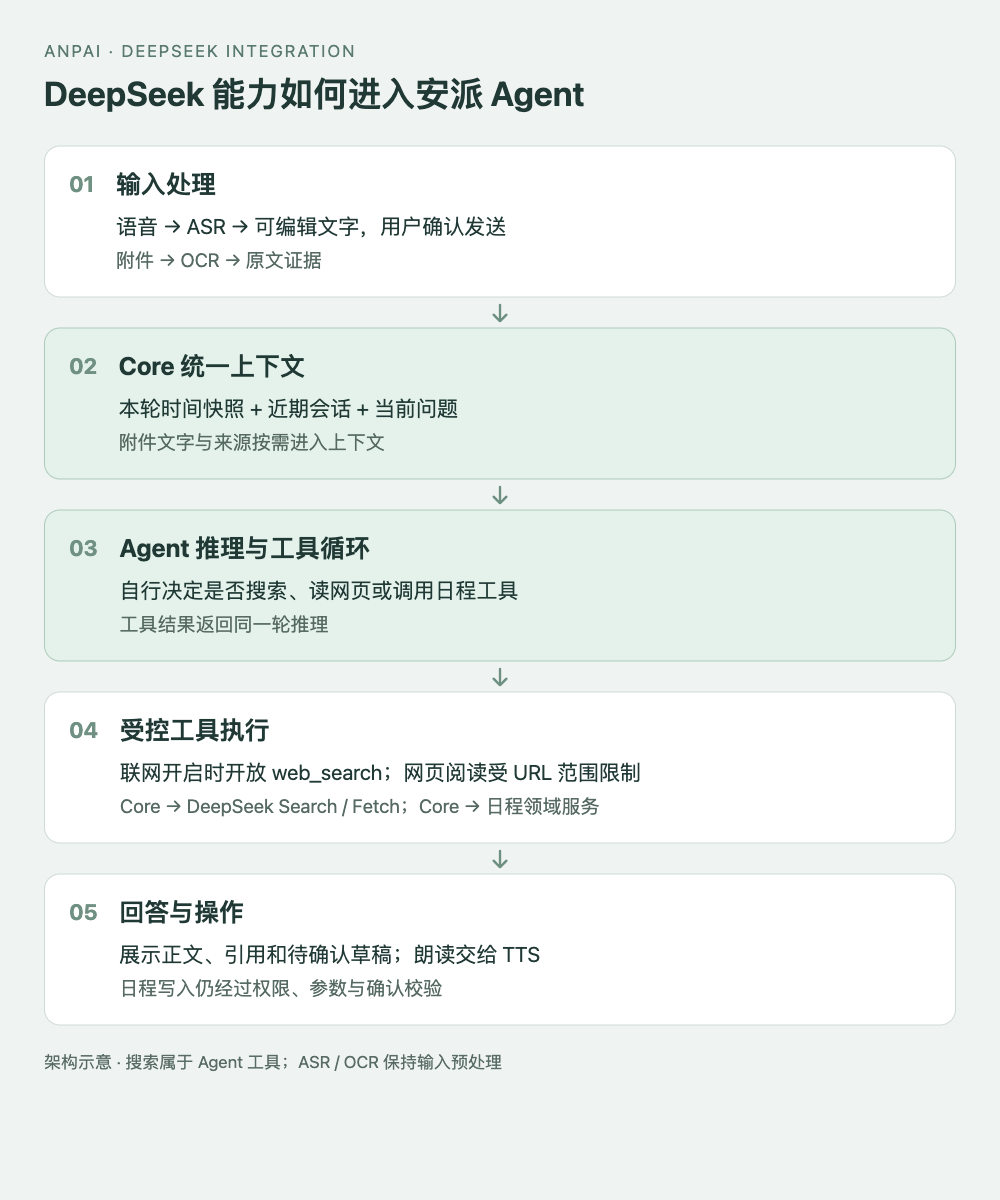
以下为本次实现的职责分工示意。搜索结果回到工具循环,OCR 和语音转写则从输入侧进入。
2 搜索注册为每轮 Agent 工具
图中搜索与阅读都是条件路径:开关开启后,Agent 可以直接回答,也可以搜索、阅读原文,再根据证据决定是否继续检索。关闭主动搜索后,用户明确提供的链接仍可阅读。
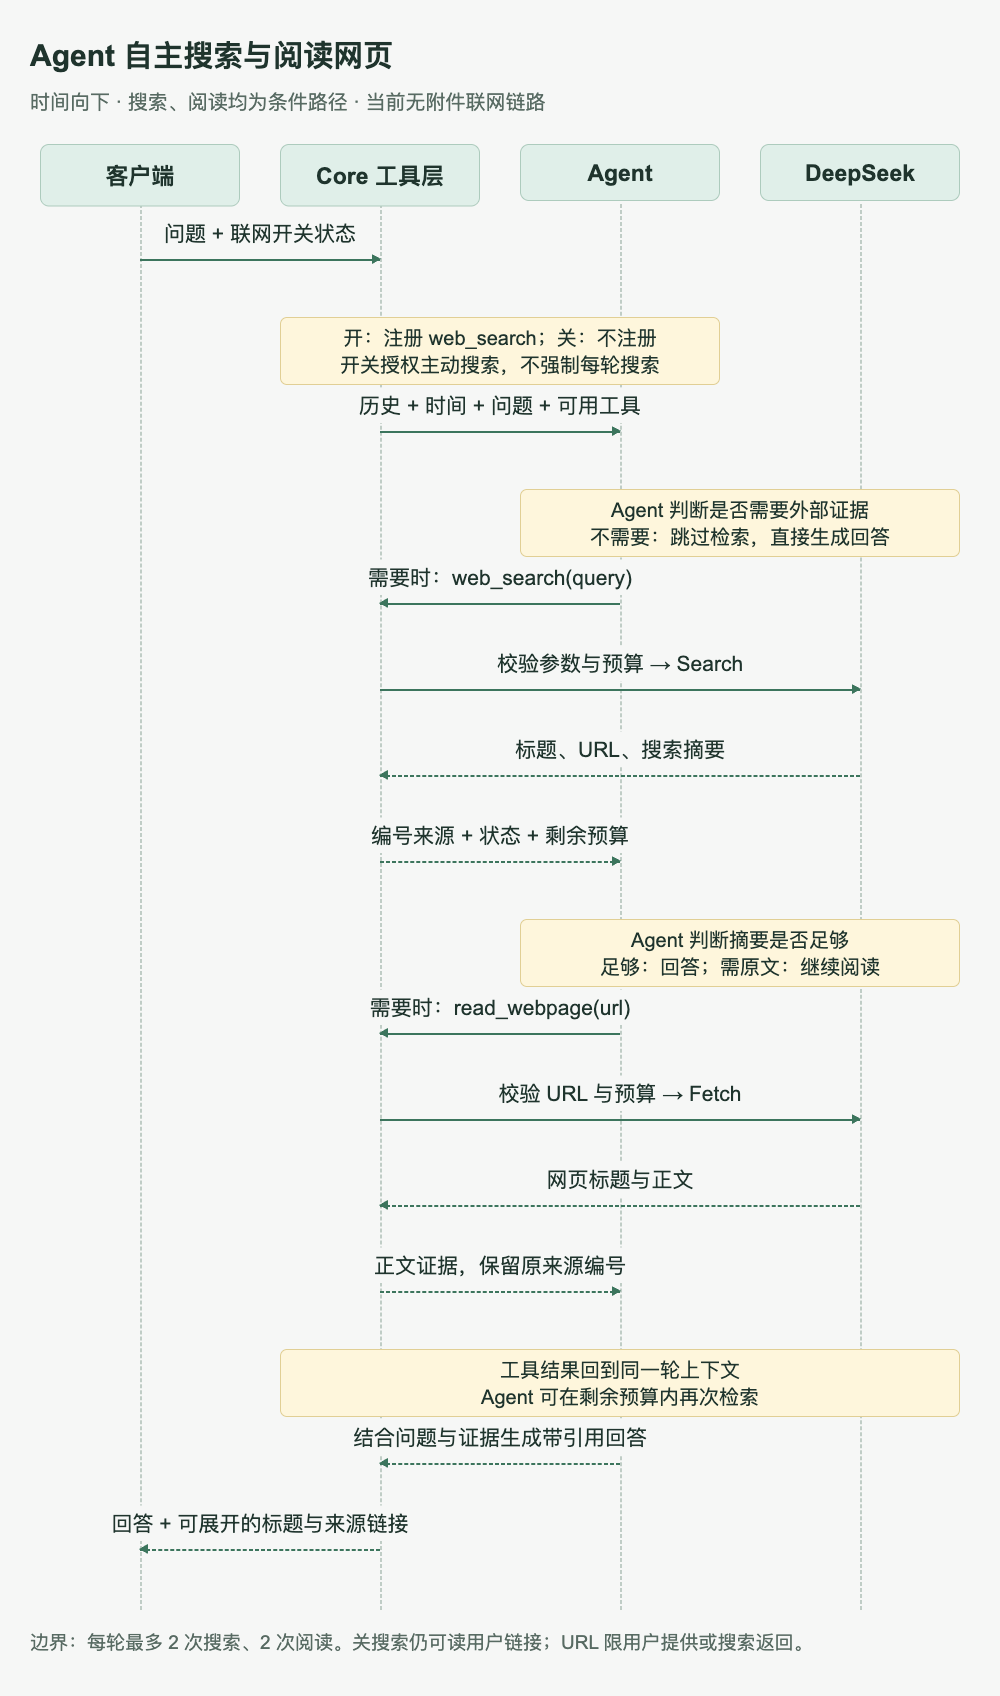
联网开关决定本轮是否注册 web_search。模型收到工具描述与参数 schema,自行决定查询词、调用时机,以及是否继续阅读网页。下面是 AgentWebTools.tools() 的结构节选,省略 execute 函数体和可选时区字段:
if (this.searchEnabled) tools.push({
  name: 'web_search',
  label: '联网搜索',
  description: 'Search the public web with your query.',
  parameters: {
    type: 'object',
    additionalProperties: false,
    required: ['query'],
    properties: {
      query: { type: 'string', minLength: 1, maxLength: 128 },
    },
  },
  executionMode: 'sequential',
  execute: async (_id, params, signal) => { /* 调用适配层 */ },
});
调用循环如下,属于流程伪代码;工具结果需要按所用 SDK 的协议关联调用 ID:
while (withinTurnBudget()) {
  const response = await model.generate({ messages, tools });
  if (!response.toolCalls.length) return response.text;

  messages.push(response);
  for (const call of response.toolCalls) {
    const result = await executeValidatedTool(call);
    messages.push(toToolResult(call.id, result));
  }
}
每轮创建一个 AgentWebTools 实例,里面保存计数器、来源数组和允许阅读的 URL 集合。执行层限制两次搜索、两次阅读;可读地址来自用户输入或本轮搜索结果。关闭主动搜索后,用户明确提供的链接仍可阅读。
工具返回保留状态、时间基准、来源编号和剩余预算。下面是返回结构示意,不是真实检索记录:
{
  "status": "ok",
  "timeContext": { "...": "本轮时间快照" },
  "sources": [
    {
      "number": 1,
      "title": "示例图书馆开放时间",
      "url": "https://example.org/hours",
      "text": "来源正文",
      "evidenceType": "webpage"
    }
  ],
  "remaining": { "searches": 1, "reads": 1 }
}
collect() 按 URL 合并来源。摘要被网页正文替换时沿用原编号,所以正文里的 [1] 不会因为继续检索而指向另一篇文章。前端据此保留引用标识,并将标题和超链接放进默认折叠的来源列表。网页内容被标记为不可信资料;这属于输入边界,不能仅靠一句提示词保证绝对安全。
3 统一上下文入口
一次实际故障是:助手查完资料后问是否创建提醒,用户回复“可以”,助手却重新询问要安排什么。联网和附件回答分支没有完整带入历史;原来的逐条 800 字截断还可能删掉助手结尾的提议。
修复后,各分支通过同一套历史选择与角色转换逻辑装载对话。下面是上下文组成的伪代码,字段名用于解释职责:
const context = {
  system: agentInstructions,
  time: turnTimeContext,
  history: selectConversationHistory(recentMessages),
  evidence: attachmentTextAndToolResults,
  currentMessage: userMessage,
  tools: enabledTools,
};
当前从归档装载最近 30 条消息,历史文本预算为 48,000 字符,按用户消息起始划分轮次,从新到旧选择完整轮次。若最新一轮本身超限,保留各消息首尾并标记中间省略。这个预算只约束历史文本,不等于整个请求的 token 预算,也尚未实现语义摘要压缩。
时间快照在请求入口创建一次。实际类型如下:
export interface TurnTimeContext {
  readonly startedAt: string;
  readonly timezone: string;
  readonly localDate: string;
  readonly localTime: string;
  readonly weekday: string;
  readonly selectedDate?: string;
}
实现用 AsyncLocalStorage 将快照传给下游。查询地点后来确定时,deriveTurnTime() 用原来的 startedAt 换算时区,不重新读取当前时钟。这样,23:59 发起、00:01 完成的请求仍有同一个参考时刻。selectedDate 独立表示日历正在查看的日期,避免把“这一天”和“今天”混在一起。
“可以”指向哪个提议、邀请函里的“明天”以哪天为基准,由 Agent 根据上下文推理。身份归属、参数合法性和日历写入约束仍由服务端检查。
4 OCR 同时处理空结果和证据归档
当前图片链路先做 OCR,再将文字交给 Agent。图中展示的是应用调用顺序;它不描述 DeepSeek 内部视觉模型的实现,也不代表问答模型直接接收原图。
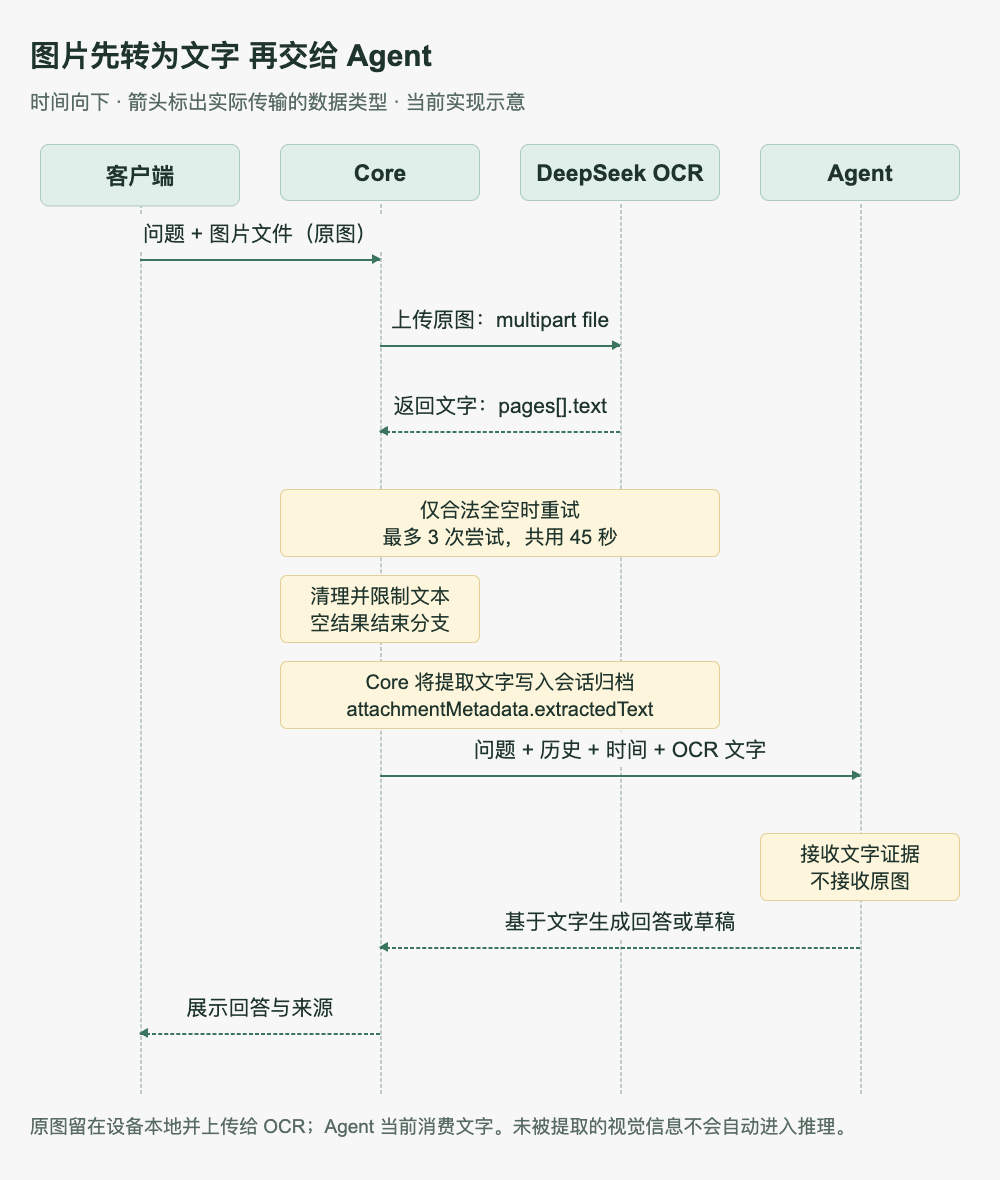
OCR 请求使用 multipart,包含 file 和 purpose=text_recognition。我们遇到过 HTTP 200 但所有页面文字为空的响应,因此成功条件落在 pages[].text 上。
下面是 recognizeDocument() 的核心逻辑节选:
const deadline = AbortSignal.timeout(45_000);
const recognitionSignal = signal
  ? AbortSignal.any([signal, deadline])
  : deadline;

for (let attempt = 0; attempt < 3; attempt++) {
  recognitionSignal.throwIfAborted();
  result = await (
    await this.post('ocr', form, recognitionSignal)
  ).json();

  if (result?.error || !Array.isArray(result?.pages) ||
      result.pages.some(page => typeof page?.text !== 'string')) {
    throw new ServiceUnavailableException('Document recognition failed');
  }
  if (result.pages.some(page => page.text.trim())) break;
}
三次尝试共用 45 秒期限,只重试结构合法但全空的响应;传输和结构错误直接报错。三次后仍为空,返回空来源,不能伪造识别成功。提取文本上限为 14,000 字符,截断时附不完整标记。
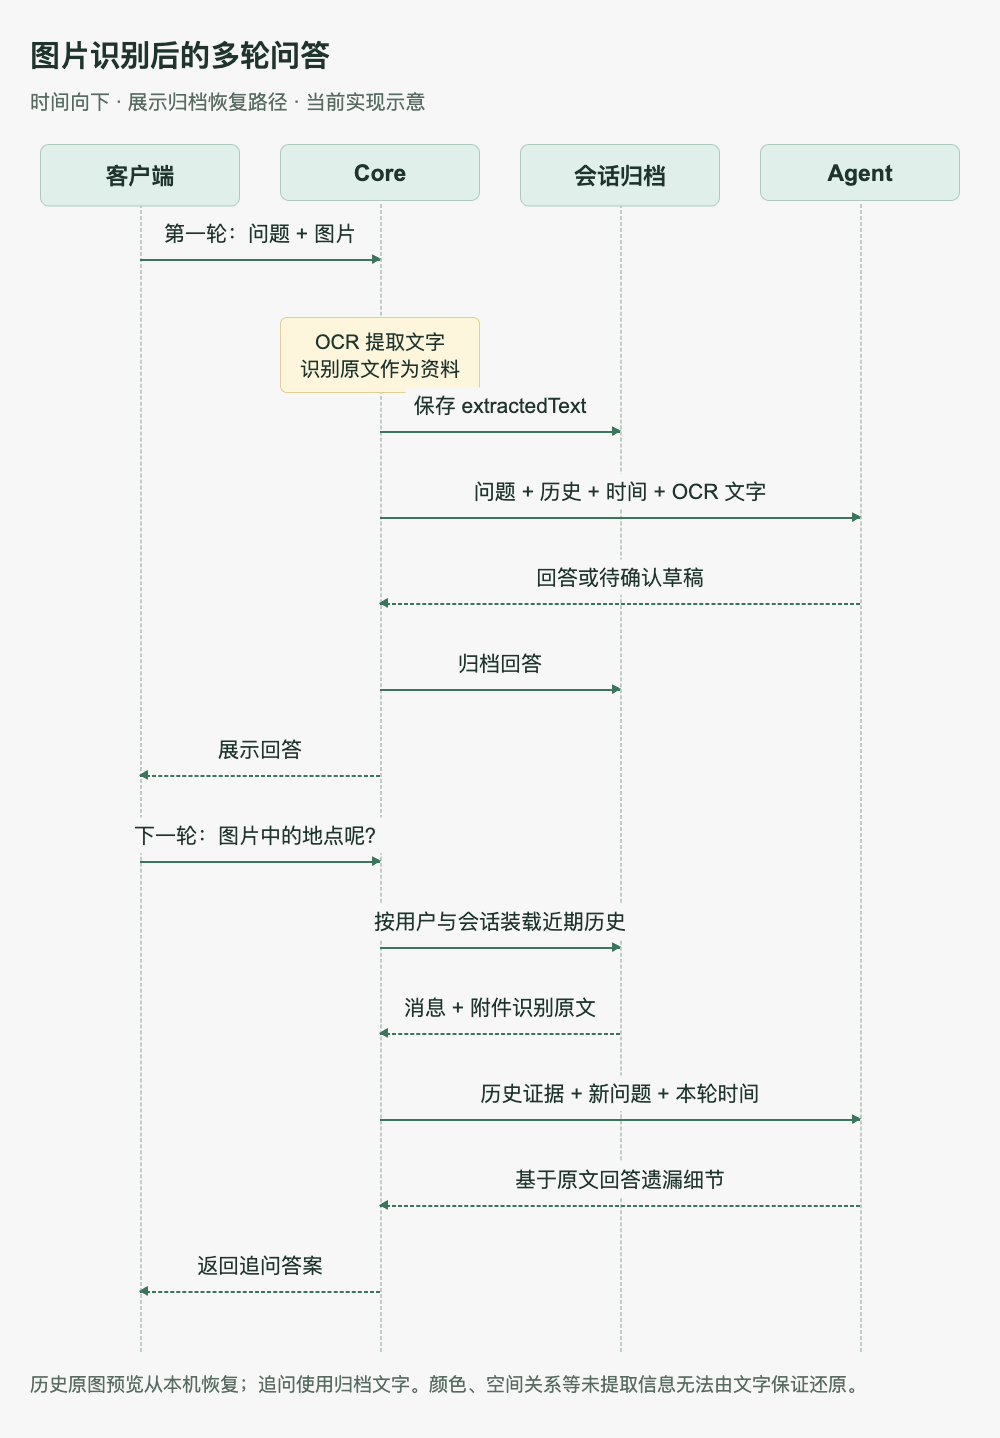
另一个问题发生在下一轮:OCR 读出了地点,但助手回答只选取了其他信息。若归档只存回答,用户再问地点就无据可查。现在将提取文本放进附件元信息:
attachmentMetadata: {
  name: string;
  type: string;
  size: number;
  sha256: string;
  extractedText?: string;
} | null;| 数据 | 保存位置 | 用途 |
|---|---|---|
| 原文件 | 设备本地,Web 使用 IndexedDB | 重开对话后展示、预览附件 |
| 文件元信息 | 服务端会话归档 | 识别附件、关联消息 |
| extractedText | 服务端会话归档 | 后续追问恢复原始文字证据 |
原图没有持久化到服务端对象存储,但识别时仍会上传给 OCR 服务。换设备或清理本地存储后,原文件需重新选择。验收时要追问一个上一轮回答没有提及、OCR 原文却包含的细节,才能验证证据恢复。
识别与追问分成两轮。第二轮通过会话归档恢复 extractedText,无需重新上传图片或重新 OCR;恢复范围仍受历史装载预算限制。
5 语音输入与 PCM 流式朗读
ASR 保持“录音 → 转写 → 可编辑输入框 → 手动发送”。时间快照在发送时创建。录音直达日程的代码保留,本版关闭。
朗读使用最终回答调用 TTS,服务端请求为:
const response = await this.post(
  'tts',
  { text: input, format: 'pcm' },
  signal,
);
// 校验 Content-Type 包含 audio/pcm 后返回响应流
return response.body;
当前朗读输入限制为 2,000 字符。浏览器播放器按单声道、24 kHz、16-bit little-endian PCM 处理,边接收边排入 Web Audio 播放队列。最容易漏掉的细节是:网络 chunk 可能截断一个两字节采样。
PCM 保存连续采样值,网络分块边界与采样边界并不一致。下面展示首块播放与后续块传输交错进行的过程;每个块都重复拼接、转换和排队。
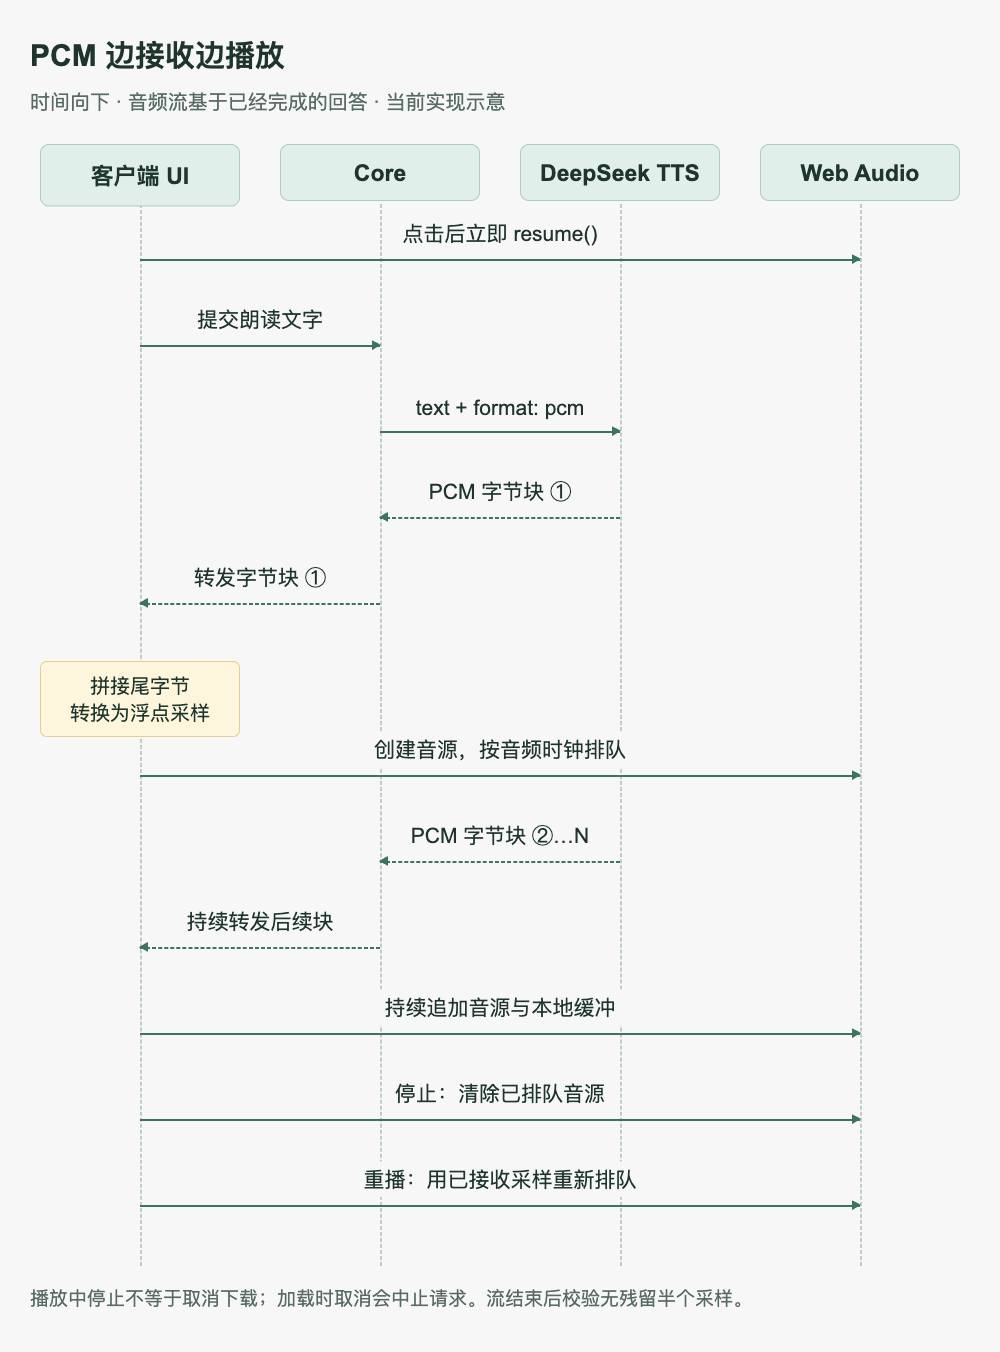
下面节选自 AgentPcmPlayer.push():
const joined = this.tail === null
  ? bytes
  : Uint8Array.from([this.tail, ...bytes]);
this.tail = joined.length % 2 ? joined[joined.length - 1] : null;

const count = Math.floor(joined.length / 2);
const view = new DataView(joined.buffer, joined.byteOffset, count * 2);
const samples = new Float32Array(count);
for (let i = 0; i < count; i++) {
  samples[i] = view.getInt16(i * 2, true) / 32768;
}
排队播放使用音频时钟,防止相邻 chunk 重叠:
const at = Math.max(this.nextTime, this.context.currentTime + 0.08);
this.nextTime = at + buffer.duration;
source.start(at);
AudioContext.resume() 在点击事件内、等待网络之前执行,以适配 WebKit 的播放限制。停止时清除已排队音源;播放器保留已接收采样用于重播。界面用小喇叭表达加载、播放和停止状态。
首声统计在第一个非静音采样预计播放时记录,而非收到 HTTP 响应时记录;它是应用侧音频时钟指标,不是扬声器物理出声测量。这里实现的是 TTS 音频流式播放,文字仍来自已完成的回答。
6 验收连续调用和真实写入
| 验证链路 | 核对内容 |
|---|---|
| 搜索 → 简短确认 → 修改时间 | 历史角色与前一轮提议保留,工具继续执行 |
| OCR → 刷新 → 追问遗漏细节 | extractedText 被重新装载 |
| 附件 → 草稿 → 确认 → 日历读回 | 未确认不写入,重复确认不重复创建 |
| 跨午夜与时区转换 | 下游沿用 startedAt,selectedDate 独立 |
| 朗读 → 停止 → 重播 | 音源停止、缓冲可重播,首声指标口径一致 |
生产回归覆盖了 9 轮真实 API 对话;Web 验证了刷新续聊、确认保存与日历读回,macOS 正式包验证了连续对话与待确认草稿。跨午夜和夏令时边界使用自动化验证。上线观察另发现旧离线同步重试问题,独立记录处理。
当前仍采用近期轮次加字符预算。下一步需要设计保留待办、承诺与来源的会话摘要,以及长期记忆检索;这些尚未由本次接入解决。
实现入口:agent-web-tools.ts、conversation-context.ts、turn-time-context.ts、deepseek-tools.service.ts、chat-archive.service.ts、agent-pcm-player.ts。官方接口说明见 构建 Chatbot 指南,官方资料核对日期为 2026 年 11 月 15 日。
评论