离线包与容器化
📖 本章由 5 节合并而成,便于整体阅读与分享。逐节精读/修改请用本目录下的分篇源文件;配图相对路径仍有效。
本章目录
- 1 · 离线包的本质:不是缓存,是“请求被拦下来了”
- 2 · 拦截实现三种方案:shouldInterceptRequest / WKURLSchemeHandler / 本地 Server
- 3 · 更新、增量与灰度:前端改了一行,用户何时拿到
- 4 · 预热池与容器公共能力:壳给了前端什么,为什么不是浏览器给的
- 5 · 容器演进:单页 → 多标签 → 小程序式容器
- 本章术语表
1 · 离线包的本质:不是缓存,是“请求被拦下来了”
1.1 问题引入
运营甩来一个竞品 App:同样是活动 H5,人家点进去首屏几乎是“贴脸”出来的,你的首页要先白屏 1.5 秒。你开 Charles 想抓包找差距,却发现竞品里很多资源请求根本没出现在抓包列表里——不是请求快,是发都没发出去。
再想一个日常体验:在飞机上、电梯里,某些 App 里的 H5 页面照样能打开。断网都能打开的“网页”,靠的是什么?
答案是本阶段的主题:离线包。总章把离线包列为“容器能力”之一,这一篇先建立它的正确心智模型,再用一个最小 demo 亲手摸一遍。
1.2 先破误区
• 误区 一:“第二次打开快,是因为 HTTP 缓存做得好;离线包就是高级版缓存。” • 事实:HTTP 缓存拦在响应侧——响应回来后按
Cache-Control/ETag存,下次复用,前提是第一次真的请求过。离线包拦在请求侧——资源早就躺在 App 里,请求出去之前就被替换成本地文件,首次进入就能命中,0 网络往返。方向相反,根本不是一回事,术语上也不允许混用(离线包 ≠ 缓存)。
• 误区 二:“有 Service Worker(SW)就不需要离线包了。” • 事实:三者机制完全不同,放一张表对照:
| HTTP 缓存 | Service Worker | 离线包 | |
|---|---|---|---|
| 机制 | 靠响应头,内核按 HTTP 语义存取 | 靠 JS:页面注册 SW 脚本,在 fetch 事件里自己决定回什么 |
靠资源打进 App / 按版本下载到本地,请求被容器拦截后映射到本地文件 |
| 生效前提 | 访问过才有 | 访问过并注册成功才有 | App 装好 / 包预下载完就绪,首次进入即可命中 |
| 控制方 | 前端 + 服务端(响应头) | 前端 | 客户端容器 + 发布系统 |
| iOS 现状 | 正常 | 受 App-Bound Domains 等策略约束,能力受限 | 不依赖 SW,容器自主可控 |
一句话:缓存靠响应头、SW 靠 JS、离线包靠“打包进 App + 请求拦截映射”。缓存与 SW 是 Web 层自己的努力,离线包是容器(壳)提供的系统能力——这也是为什么它是本阶段而不是阶段 5/6 的内容。
1.3 原理讲解:加载流程
1.3.1 一条请求的“分岔路口”
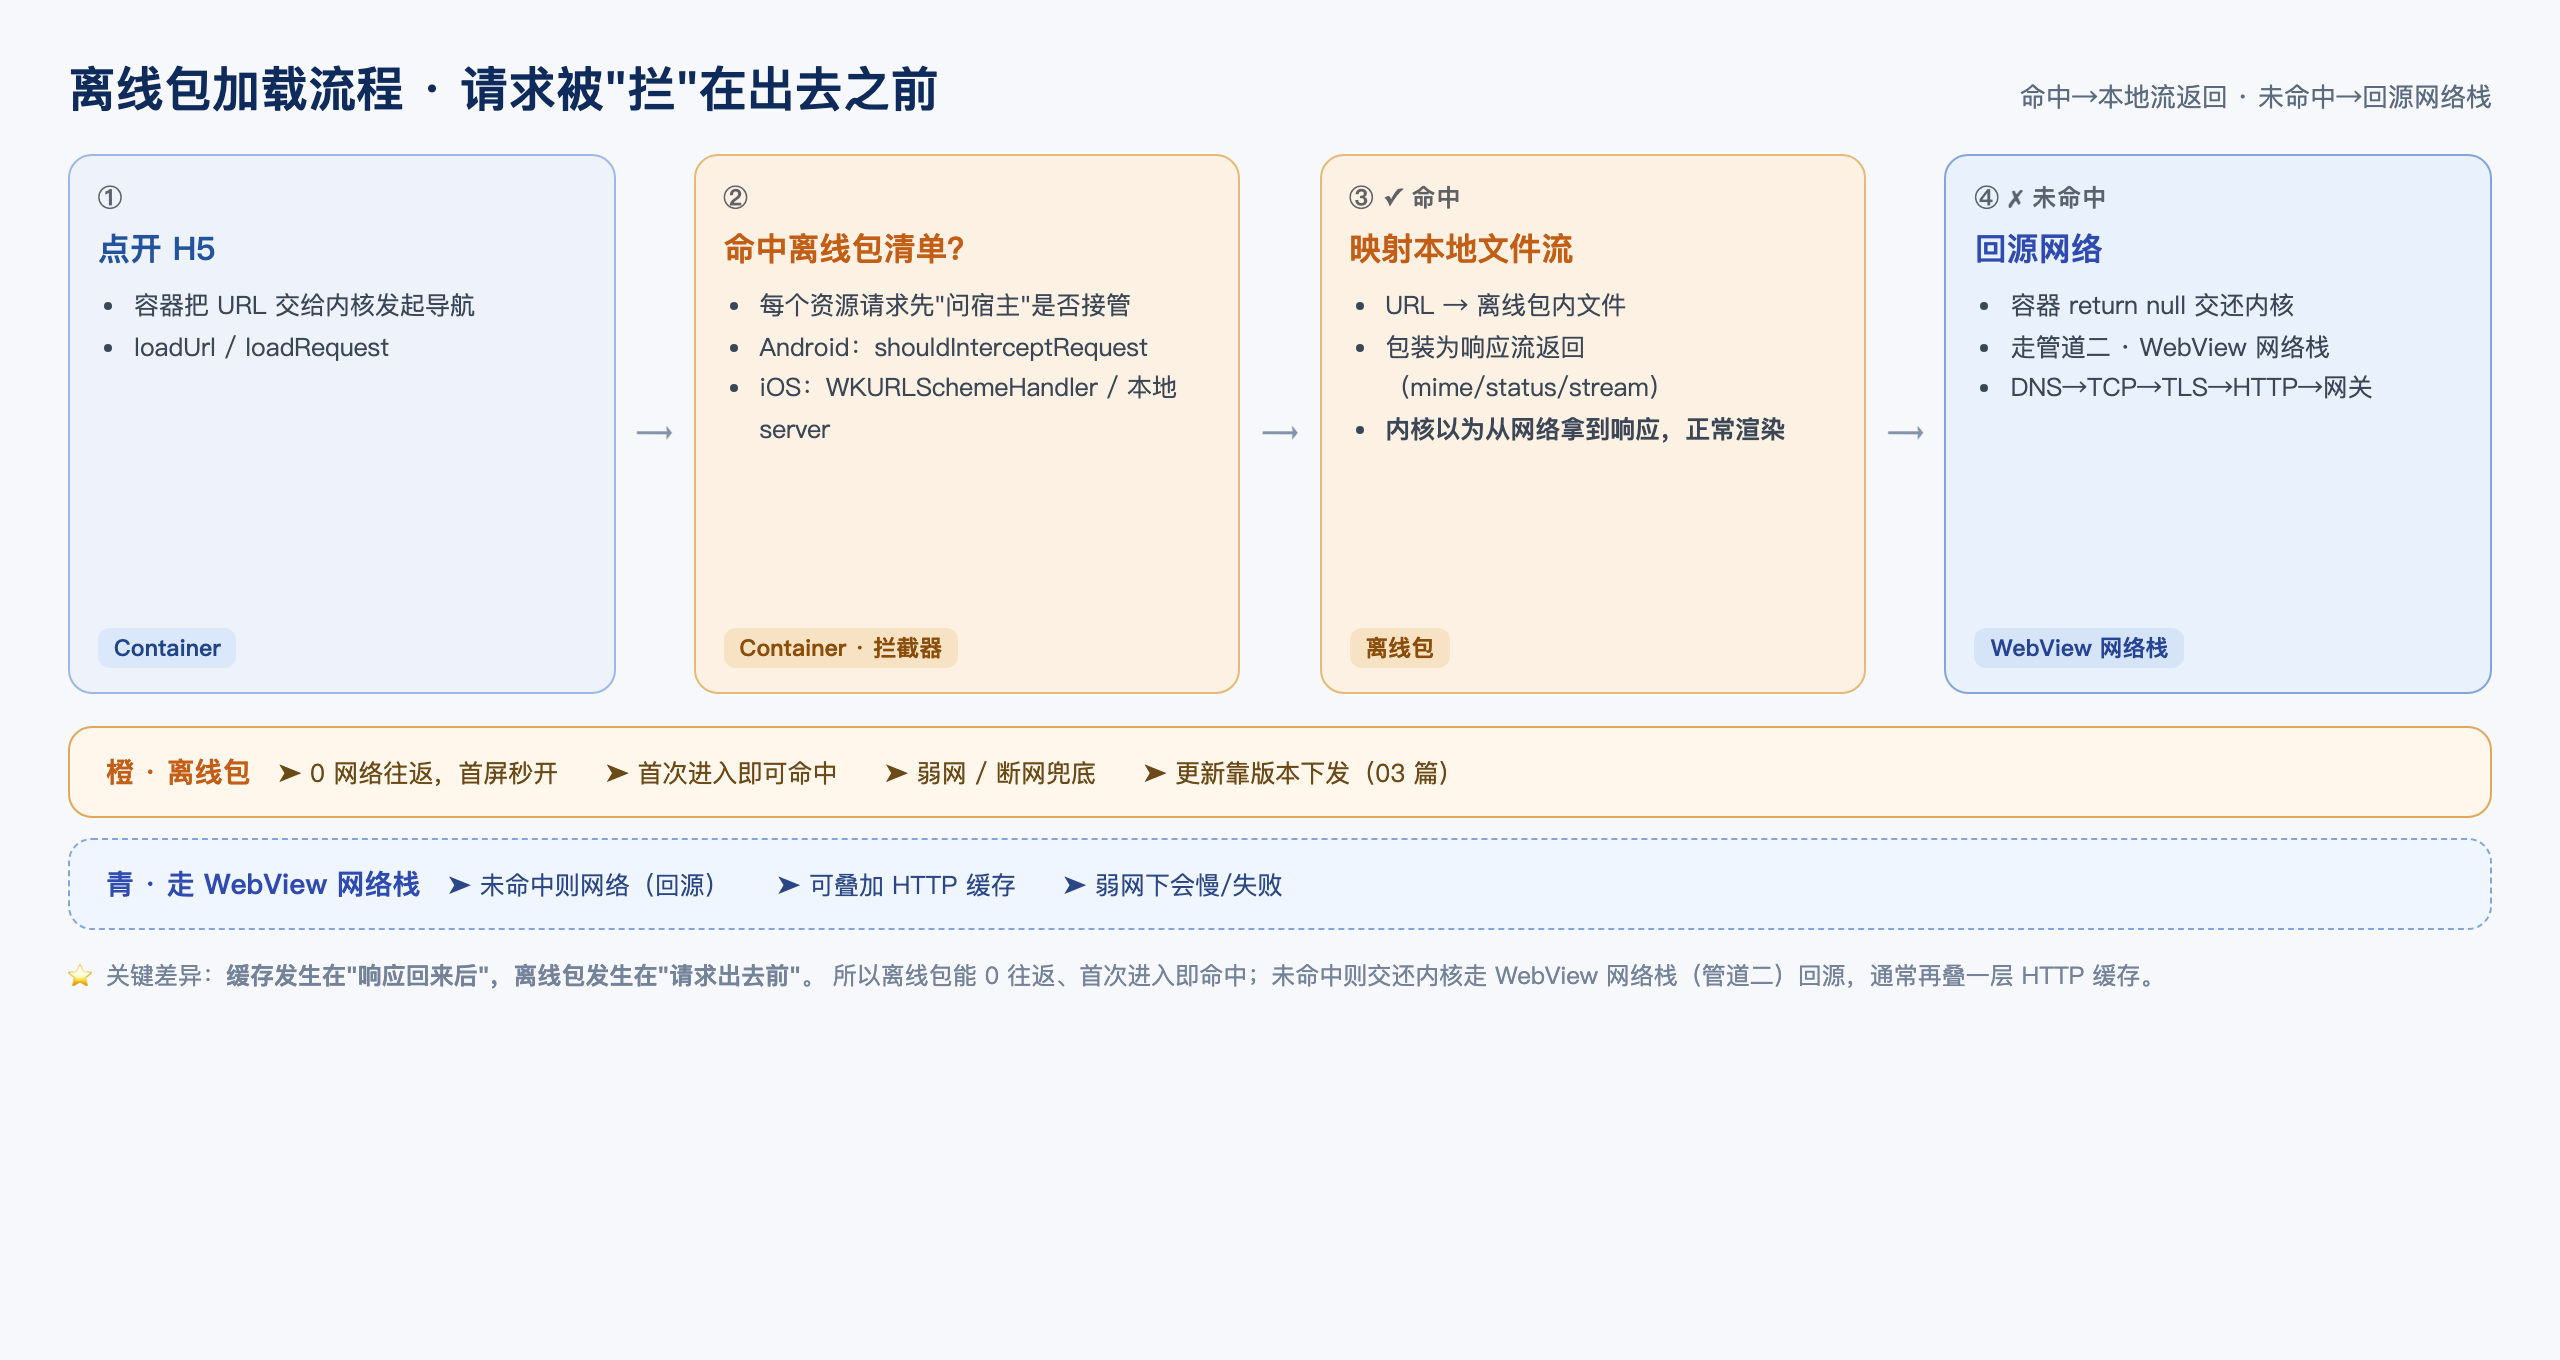
用户点开一个 H5,到资源真正可用,中间的分岔路口只有一个:
- 用户点 H5,容器把 URL 交给内核发起导航(
loadUrl/loadRequest); - 内核对每一个资源请求(主文档、CSS、JS、图片、XHR……)先“问宿主一句”:这个请求你要不要接管?——Android 侧的入口是
WebViewClient.shouldInterceptRequest(iOS 侧的等价机制在 02 篇展开); - 容器拿 URL 去查离线包清单:这个 URL 属于哪个包、对应包内哪个文件(映射规则见本节 1.3.3);
- 命中 → 打开本地文件流,包装成一个标准 HTTP 响应(mime / encoding / 状态码)交给内核。对内核来说,它以为自己从网络拿到了响应,接下来正常解析渲染;
- 未命中 → 容器不接管(Android 返回
null),请求回源走网络——也就是总章讲的管道二 · WebView 网络栈,通常再叠加一层 HTTP 缓存; - 离线包的版本更新发生在“更早的时机”(冷启动、进入页面前,见 03 篇),与这条请求路径无关。
记住关键差异:缓存发生在“响应回来后”,离线包发生在“请求出去前”。所以离线包能做到 0 往返,而缓存再快也至少要一次协商。
1.3.2 为什么它能“首屏秒开 + 弱网兜底”
- 首屏秒开的账:正常路径一个主文档 + N 个资源,每个至少 DNS→TCP→TLS→HTTP 的 1~N 个 RTT;离线包命中的路径只剩一次磁盘读。HTML/CSS/JS 全在本地后,首屏耗时里网络归零(接口仍走网络,除非配合数据预取——04 篇)。
- 弱网兜底:地铁、电梯、超时重试,本地资源照样命中;完全断网时页面“壳”也能打开并渲染离线内容,只剩接口失败可提示。这是缓存做不到的——缓存必须先“有一次成功响应”。
1.3.3 离线包的 “IDO 三要素”
任何一套离线包体系,无论叫什么名字,都在回答下面三个问题:
| 要素 | 要回答的问题 | 容器里的形态 |
|---|---|---|
| Identify 识别 | 一条 URL 到底属不属于某个包?对应包内哪个文件? | 清单(manifest):URL 前缀 / 域名 → 包 ID + 版本 + 文件列表;拦截器按规则把 URL 映射为包内路径 |
| Download 分发 | 包怎么进到手机里? | 打包(构建产物 zip + 校验签名)、全量 / 差量(bsdiff 等)、分包(主包随 App 内置,业务包按需 / 预载下载) |
| Update 更新 | 版本怎么定、谁说了算? | 版本清单位置、强更 / 弱更、灰度下发、与 App 版本对齐(详见 03 篇) |
前端要建立的条件反射是:Identify 规则决定了你的 URL 怎么写才能被命中。比如容器约定“同域 + 该前缀的请求走离线包”,你的静态资源就应该全部收敛到一个可枚举的域名/路径前缀下;散落到第三方 CDN 的资源,容器想管也管不到。
1.4 代码验证:最小离线包(Android · shouldInterceptRequest)
把 index.html + main.css + main.js 打进 App 的 assets/offline/,然后让 WebView以为在访问线上域名,实际上每个请求都被拦下来读本地:
// 平台:Android(Kotlin)
// 用途:最小离线包命中演示(配套 demo/stage-7-offline-container/OfflinePackActivity.kt)
class OfflinePackActivity : AppCompatActivity() {
    private val offlineRoot = "https://h5.example.com/"   // 约定:该前缀下的请求走离线包

    override fun onCreate(savedInstanceState: Bundle?) {
        super.onCreate(savedInstanceState)
        val webView = WebView(this)
        setContentView(webView)
        webView.settings.javaScriptEnabled = true

        webView.webViewClient = object : WebViewClient() {
            override fun shouldInterceptRequest(
                view: WebView, request: WebResourceRequest
            ): WebResourceResponse? {
                val url = request.url.toString()
                if (!url.startsWith(offlineRoot)) return null       // 不归我们管 → 回源
                val path = url.removePrefix(offlineRoot).substringBefore('?')
                val file = "offline/$path"
                return try {
                    val mime = when {
                        path.endsWith(".html") -> "text/html"
                        path.endsWith(".css")  -> "text/css"
                        path.endsWith(".js")   -> "application/javascript"
                        else -> "application/octet-stream"
                    }
                    WebResourceResponse(mime, "utf-8", assets.open(file))  // 命中:本地流当响应
                } catch (e: Exception) {
                    null                                            // 包内没有 → 交还内核回源
                }
            }
        }
        webView.loadUrl("https://h5.example.com/index.html")
    }
}
跑起来后用 chrome://inspect 观察:Network 面板里请求 URL 仍是线上域名,但抓包工具里看不到任何流量;拔掉网线页面照样完整打开——这就是“命中离线包”的判定特征。完整的可运行文件(含 index.html/css/js)在 demo/stage-7-offline-container/(示例代码详见 demo 包)。
三个必须知道的实现细节:① shouldInterceptRequest 在后台线程回调,不能碰 UI;② 主文档也会走这个回调,所以要拦截就一起拦;③ 想表达“不接管”必须 return null,返回一个空 WebResourceResponse 会直接把页面搞挂。
1.5 坑点清单
| 坑 | 现象 | 根因 | 解法 |
|---|---|---|---|
| mime / encoding 给错 | 样式不生效、JS 不执行、console 刷 “Resource interpreted as…” | WebResourceResponse 三个参数随手填 |
按扩展名映射 mime,文本资源统一 utf-8 |
| 未命中却返回空响应 | 页面转圈不加载 | 想表达“不拦”却 new 了个空对象 | 未命中一律 return null 交还内核 |
| 命中判断时灵时不灵 | 带活动参数的请求漏拦 | 用完整 URL 匹配,页面带着 ?channel=xx |
匹配前去掉 query / fragment,按路径映射 |
| 后台线程碰 UI | 偶发 ANR / 崩溃 | 在拦截回调里直接操作 View / Toast | 拦截器只查清单、开文件流,UI 交给主线程 |
| 包内文件缺失 | 白屏、资源加载失败,且没有网络请求痕迹(排查容易跑偏) | 清单与文件不同步、差量合成失败 | 打开流失败时回源 + 上报,归因时先怀疑包(03 篇对账表) |
1.6 自测题
- “离线包本质上是给 HTTP 缓存换了个存储位置” —— 错在哪?
- 用户第一次安装 App 就点开接入离线包的 H5,能命中吗?HTTP 缓存呢?为什么?
shouldInterceptRequest里命中失败时返回一个空的WebResourceResponse会发生什么?正确写法是什么?- 运营反馈“竞品抓包根本抓不到静态资源请求”,请给出两种可能解释(至少一种和离线包无关)。
- 动手:跑通 demo,然后在
assets/offline/里删掉main.js再打开页面,观察现象并解释为什么“删掉后白屏无报错”是离线包体系的经典故障。
参考答案(思考后再点开)
- 机制方向相反:缓存拦在响应侧(响应回来后存、下次复用,且必须先访问过一次);离线包拦在请求侧(请求出去前就被替换成本地文件,首次进入即命中、0 网络往返),控制方也从“前端+服务端”变成“客户端容器+发布系统”。
- 能。离线包的资源随 App 内置或提前下载,首次进入即可命中;HTTP 缓存必须先有一次成功响应才有得复用,首次全走网络。
- 内核会把这个空响应当成“服务端真的回了它”,主文档拿到空 HTML 直接白屏/报错。正确做法是
return null,表示不接管,交还内核回源请求。 - 可能一:资源命中离线包,请求根本没发出去,抓包自然看不到;可能二:该 App 自研内核走了私有通道/HTTPDNS+QUIC 等抓包工具不解析的协议(或请求被容器转交客户端网络库发放,见阶段 6)。
- 删除后拦截器照常命中清单、打开流抛异常 → 若没有兜底回源逻辑就会
return null回源请求一个“线上不存在(或慢)的文件”,表现为白屏且资源失败不完全是网络问题——这类“清单与文件不同步”必须靠回源兜底 + 完整性校验 + 上报定位。
2 · 拦截实现三种方案:shouldInterceptRequest / WKURLSchemeHandler / 本地 Server
2.1 问题引入
同一个容器团队,离线包需求排期:Android 侧一周内就上线了,iOS 卡住半个月。客户端同学的解释是:“iOS 没办法拦 https。“前端听得一头雾水——阶段 6 明明说过 Android 就是用 shouldInterceptRequest 拦 https 的,大型厂 App 的 iOS 离线包也从来没缺过。到底是怎么实现的?
2.2 先破误区
• 误区:“iOS 的
WKURLSchemeHandler也能拦http(s),只是写法不同。” • 事实:WKURLSchemeHandler只能接管自定义 scheme(http/https/file等系统保留 scheme 注册 handler 会直接抛异常,无法注册)。所以 iOS 上“让离线包生效”从来不是“拦 https”,而是换 URL 的承载方式:要么让页面跑在自定义 scheme 上,要么起本地 server。Android 的shouldInterceptRequest可以拦http(s),但也不是万能的(Service Worker 接管的请求、POST 等场景行为差异,以实测为准)。
2.3 原理讲解:三种资源映射方案
回看 01 篇的加载流程图:离线包的核心动作是“请求被拦下来 → 映射本地文件流返回“。三个方案差别只在”拦在哪、以什么形态返回“。
2.3.1 方案 A:Android shouldInterceptRequest
WebViewClient.shouldInterceptRequest(view, request) 对每一个资源请求(主文档、子资源、XHR)回调一次,返回:
WebResourceResponse(mimeType, encoding, InputStream):命中,用包内文件流当响应。必要时还可setStatusCode、setResponseHeaders补充状态码和响应头;null:不接管,内核继续走自己的网络栈(管道二)回源。
形态上它就是“给了你一次亲手写响应的机会”:mime 决定内核怎么解析,encoding 决定文本解码,stream 决定字节从哪来。URL 保持线上域名不变,所以 Cookie、referrer、前端路由、埋点全部无感——这是它最大的优点。
2.3.2 方案 B:iOS WKURLSchemeHandler(自定义 scheme)
WKWebViewConfiguration.setURLSchemeHandler(_:for:) 把一个 handler 绑到自定义 scheme(如 x-offline)上,页面通过 WKWebView.load(URLRequest(url: URL(string: "x-offline://pack/index.html")!)) 加载。之后:
- 每个该 scheme 的请求都会回调
webView(_:start:),拿到URLSchemeTask; - handler 调
task.didReceive(response)→didLoad(data)→didFinish()把本地内容“喂”回内核; - 取消时回调
webView(_:stop:),stop 之后 task 的任何回调会崩溃,工程里必须登记请求生命周期。
把页面主文档整个 load 在 x-offline:// 上,HTML 里的相对路径资源天然解析成同 scheme,也就全部走进 handler——这是“用自定义 scheme 承载离线包”的常见做法。但有几个边界要心里有数:
- 主文档 URL 变成了
x-offline://…,依赖线上域名做判断的代码全部走样:Cookie 按域归属会失效、referrer 不是https://…、部分埋点取location.host拿到的是空/异常、postMessage的event.origin变成自定义 scheme、老式“只用 http(s) 的判断”也会误判。多数容器会刻意把离线页的“业务 API 请求”仍指向真实线上域名(走 bridge 或代理),从而把“壳承载”和“接口仍走网络”分开。 - Service Worker 与子资源解析在该模式下的表现更依赖内核行为:自定义 scheme 页面上注册/命中 Service Worker、
importScripts、动态 import、Web Worker 等都可能和自己想的差很远——这些组合的实际表现以你们的内核实测为准,上 container 之前必须用你们真实的前端页面回归一遍,而不是套用纯浏览器的结论。
所以“能用自定义 scheme 承载离线包”是真的,但它从来不是“无脑切过去”。切过去之后要额外验证的同源/域/Cookie/referrer/子资源问题,往往就是它最大的隐性成本。
2.3.3 方案 C:本地 HTTP Server
在 App 进程里起一个监听 127.0.0.1:port 的 HTTP server(Android 常用 NanoHTTPD,iOS 常用 GCDWebServer 一类),把根目录指向包所在磁盘目录。两种用法:改写 URL(H5 的 URL 被容器改写成 http://127.0.0.1:port/pack/index.html)或代理(server 收到请求后转发/拼装)。明文限制必须处理:Android 9+ 默认禁明文,要在 networkSecurityConfig 里单独放行 127.0.0.1;iOS 需要为本地回环地址配 ATS 例外(具体键位以实测为准)。
它的历史价值在于:在拦截 API 还不好用的年代,以及某些“需要真实 HTTP 语义”(真实请求/响应链路、抓包友好)的场景里,它是唯一解。代价是引入了一个需要管理生命周期的进程内服务。
Android 侧的明文放行要专门写(iOS 的 ATS 例外要看工程实际 Info.plist,以实测为准):
<!-- 平台:Android 9+(API 28+),贴进 res/xml/network_security_config.xml 并在 Application 引用 -->
<network-security-config>
    <domain-config cleartextTrafficPermitted="true">
        <domain includeSubdomains="false">127.0.0.1</domain>
        <domain includeSubdomains="false">localhost</domain>
    </domain-config>
</network-security-config>给前端一个识别线索:如果你们 App 的 H5 页面 URL 是 http://127.0.0.1:某端口/… 开头——这就是历史上走过本地 server 路线的容器留下的印记,属于方案 C 的活化石。
2.3.4 优缺点对照
| 维度 | A:Android shouldInterceptRequest | B:iOS WKURLSchemeHandler | C:本地 HTTP Server |
|---|---|---|---|
| 拦截面 | http(s) 主文档 + 子资源,全量 |
仅自定义 scheme | 可改写/代理,全量 |
| URL 一致性 | 保持线上域名,Cookie/referrer/埋点无感 | 页面 URL 变 x-offline://… |
URL 变 127.0.0.1:port |
| HTTPS/证书 | 本地流,无 TLS 概念 | 同左 | 要绕明文限制(Android 9+ 网络安全配置 / iOS ATS 例外),自签证书则要信任配置 |
| 端口占用 | 无 | 无 | 有,冲突需探测重试 |
| 调试 | chrome://inspect 里 URL 正常,被命中的请求不出现在抓包 |
Safari 检查器 URL 是自定义 scheme | 抓包/联调行为特殊,要多教一次排查方法 |
| 引入成本 | 系统 API,最低 | 系统 API,最低 | 需引入并维护 server 生命周期 |
结论:多数容器用“拦截方案”而非“自建 server”——它不引入额外端口与协议层,Cookie/域名/调试心智与线上页保持一致,成本最低。本地 server 方案如今多用于拦截 API 覆盖不了的特殊场景(需要真实 HTTP 栈、或容器同时要把请求转交客户端网络库的桥接层)。
选型时也不要只看“能不能拦”,要看三个组合维度:① 能拦到哪些 URL(Identify 规则覆盖度)。shouldInterceptRequest 可以拦;② URL 副作用能不能接受。要不要线上域名、要不要 Cookie、要不要 mock 掉 referrer;③ 回源路径可不可控。多数团队最终答案是“Android 用 shouldInterceptRequest 只拦静态资源、API 仍走原路或由 bridge 转交”,iOS 用自定义 scheme 或本地 server 补齐,两条思路在“壳对离线包的语义”上是一致的:壳决定哪些 URL 映射到本地,剩下的照常走网络。
2.4 代码验证:iOS WKURLSchemeHandler 最小实现
// 平台:iOS(Swift)
// 用途:最小离线包方案 B 演示 —— 自定义 scheme 承载离线包
// 粘贴到:任一含 WKWebView 的最小 iOS 工程

import WebKit

final class OfflineSchemeHandler: NSObject, WKURLSchemeHandler {
    private let bundleDir = "offline"   // 包内文件放在 App Bundle 的 offline/ 子目录

    func webView(_ webView: WKWebView, start task: URLSchemeTask) {
        guard let url = task.request.url else { return }
        let relative = String(url.path.dropFirst())          // "/index.html" → "index.html"
        let mime: String
        switch true {
        case relative.hasSuffix(".html"): mime = "text/html"
        case relative.hasSuffix(".css"):  mime = "text/css"
        case relative.hasSuffix(".js"):   mime = "application/javascript"
        default:                          mime = "application/octet-stream"
        }
        if let file = Bundle.main.url(forResource: relative, withExtension: nil, subdirectory: bundleDir),
           let data = try? Data(contentsOf: file) {
            let resp = URLResponse(url: url, mimeType: mime,
                                   expectedContentLength: data.count, textEncodingName: "utf-8")
            task.didReceive(resp); task.didLoad(data); task.didFinish()   // 命中:喂回本地数据
        } else {
            let resp = HTTPURLResponse(url: url, statusCode: 404,
                                       httpVersion: "HTTP/1.1", headerFields: nil)!
            task.didReceive(resp); task.didFinish()                        // 未命中:明确 404
        }
    }

    func webView(_ webView: WKWebView, stop task: URLSchemeTask) {
        // 真实工程需在此登记取消,避免 stop 后再回调 task 崩溃
    }
}

// 配置与加载:
let config = WKWebViewConfiguration()
config.setURLSchemeHandler(OfflineSchemeHandler(), forURLScheme: "x-offline")
let webView = WKWebView(frame: .zero, configuration: config)
webView.load(URLRequest(url: URL(string: "x-offline://pack/index.html")!))
跑起来后对照 01 篇 Android demo,你会看到同一件事的两种形态:Android 是“URL 不变、流被替换”,iOS 是“URL 换了个 scheme、内核把整个页面的请求都带进 handler”。
2.5 坑点清单
| 坑 | 现象 | 根因 | 解法 |
|---|---|---|---|
| iOS 注册 handler 即崩 | 启动时 NSInvalidArgumentException |
给 http/https 等保留 scheme 注册 handler |
只能注册未占用的自定义 scheme |
| task 回调后崩溃 | 未命中/取消时偶发 crash | stop 之后仍调了 didReceive/didFinish,或 didFinish 调了两次 |
登记 task 生命周期,恰好一次 finish,stop 后立即失效 |
| scheme 页面上 Cookie 丢失 / origin 校验失败 | 登录态问题只在离线包页出现 | 主文档 URL 不再是 https://线上域名,Cookie 域与同源判断变了 |
登录态走容器注入(04 篇)而非页面 Cookie;排查时先看 location.href |
| Android 明文 server 失败 | 本地 server 请求全部失败 | Android 9+ 默认禁明文 / iOS ATS | 配 networkSecurityConfig 与 ATS 本地例外(以实测为准) |
| Service Worker 场景行为怪 | 有的请求没进拦截点 | SW 接管的请求不必然走宿主拦截 API | 强化测试:SW 与拦截方案的组合以实测为准,必要时禁用 SW |
2.6 自测题
- 为什么 iOS 容器很少说“拦 https”,而 Android 侧可以?两者各自的入口 API 是什么?
WKURLSchemeHandler的start/stop生命周期里,最危险的调用错误是什么?怎么防?- 把 A/B/C 三个方案按“URL 一致性”排序,并说明为什么这一维度对埋点和 Cookie 特别重要。
- 什么场景下团队会退而选本地 HTTP Server?它的两项固有代价是什么?
- 动手:跑通本节 iOS demo,再把页面里的
main.js改成引用https://绝对路径,观察还命中吗?解释“识别规则(Identify)与承载方案(A/B/C)是两个独立维度”。
参考答案(思考后再点开)
WKURLSchemeHandler只能接管自定义 scheme,http/https是系统保留 scheme,注册会抛异常;Android 的shouldInterceptRequest是WebViewClient的标准回调,可以拦http(s)的主文档与子资源。- 在 task 被
stop之后继续调用didReceive/didLoad/didFinish,或didFinish被调用两次——都会直接崩溃。防法:handler 内维护任务登记,取消后置失效,每个任务恰好一次 finish。 - A 保持线上域名 > B 换自定义 scheme > C 换本地回环地址。Cookie 按 domain 归属、埋点常带页面 URL、referrer 校验都对 URL 平面敏感——URL 一换,这些逻辑都要重新核对。
- 需要“真实 HTTP 栈”的场景(例如拦截 API 覆盖不了的老内核、要把请求统一桥接进客户端网络库的特殊架构)。代价:端口管理与明文/ATS 政策处理、server 生命周期维护、调试链路变长。
- 绝对路径
https://请求会回到内核网络栈去回源(方案 B 下不进 handler,或按方案 A 的规则判断),说明“怎么拦”与“哪些 URL 会被拦”(Identify 规则)各自独立——识别规则没覆盖的 URL,承载方案再先进也命中不了。
3 · 更新、增量与灰度:前端改了一行,用户何时拿到
3.1 问题引入
你在 H5 里改了个文案,发版后群里有人喊“还是旧版本”。查了半天:CDN 缓存没刷新?接口没生效?都不是——用户手机里的离线包还停在上一版。H5 天然“改了立即生效”的即时性,在离线包体系里被“发布→打包→下发→命中”这条链路拖慢了。
前端要接受一个事实:离线包隔离了资源和网络,也隔离了版本。这一篇讲清楚包版本怎么管、改一行到底多久到用户、以及版本对不上会炸成什么样。
3.2 先破误区
• 误区 一:“H5 发了新版,离线包会自动变新的。” • 事实:离线包是独立于前端 CDN 的一套发布物。前端代码要同时走两条发布线:线上 CDN(供 Web/未命中回源用)和离线打包线(打成 .zip 供容器下发)。只发 CDN 不发打包线,离线包用户拿到的是老包。
• 误区 二:“JS/CSS 文件名带 hash,版本就不会乱。” • 事实:hash 解决的是“CDN 资源不可变、可强缓存”,它保证不了“容器下发的 bundle 与前端页面引用的资源一致”——恰恰是版本不对齐的高发区(见本节 3.5 的坑点清单)。
3.3 原理讲解:更新链路与策略
3.3.1 一次完整更新链路
前端改了一行文案,走到“用户手机上是新版”需要经过:
前端代码变更
  → ① 发布 CDN(线上页与回源兜底即时生效,但与离线包无关)
  → ② 构建产物打成离线包 bundle(含清单 manifest:包 version、文件表、hash)
  → ③ 平台/服务端存储该版本,按灰度策略决定放给谁
  → ④ 容器侧发现"本地包版本 < 目标版本",触发下载/差量合并
  → ⑤ 下载完成后更新本地面板,离线包清单切换
  → ⑥ 用户下次命中该 URL 时读到的就是新版文件
其中 ③④⑤ 是可异步、可延迟的——所以“改一行”到“用户手上有新版”通常以小时到天计,而不是秒。这也是离线包要配强更/弱更 + 灰度的原因。
3.3.2 包版本管理
| 概念 | 含义 | 什么时候用 |
|---|---|---|
| 全量包 | 整个 bundle 一份 zip,随 App 内置或首次下载 | 新装 / 大版本 / 首启 |
| 差量包 | 只下载相对上一版的差异(bsdiff)、本地合成 | 已装旧版、只改少量文件时,省流量省包体积 |
| 分包 | 一个 App 拆成基础包 + 若干业务包,各自独立版本 | 首页、核心页常驻/预载,长尾业务按需下载 |
| 强更 | 检测到新版本直接拉新,忽略旧包 | 有破坏性变更、不更会出事 |
| 弱更 | 静默下载新版本,下次进入生效 | 日常迭代,不打断用户 |
3.3.3 灰度的三种道具
| 道具 | 控制维度 | 典型用法 |
|---|---|---|
| 按 UID 灰度 | 用户标识(用户 ID 取模 / 白名单) | 众测、内部验证、按比例放量 |
| 按版本下发 | 客户端版本(App 版本号 / 系统版本) | 某客户端版本兼容旧包、逐步推进 |
| 按环境下发 | 预发 / 线上 / 指定域名 | 测试环境先验包完整性,再进线上 |
三者可以叠加:先按环境→再按版本→最后按 UID 放量。前端要理解,离线包的灰度是容器/平台下发层的事,前端本身没有直接开关——你只是“被灰度”的一方。
3.4 代码验证:版本对账表与“改一行要多久”
给一张可直接复制的对账表模板,排查“用户拿到哪个版本”时填它:
| 字段 | 含义 | 填什么 | 前端能做什么 |
|---|---|---|---|
bundle_version |
离线包版本(manifest 里的整数/语义化版本) | 从容器注入的读取接口拿(见 04 篇) | 页面里打日志上报,便于和线上请求比对 |
| 前端发布时间 | 你发 CDN / 打包的时间戳 | 发布记录、构建号 | 与“用户包版本”比对,判断是否在包内 |
| 用户端命中版本 | 这台设备实际用到的版本(bundle + hash 文件表) | chrome://inspect / 容器面板看本地清单 |
归因“是包旧、还是 CDN 新页引用了包内旧资源” |
排查口诀:先看 bundle_version,再看资源 hash,最后才算时序。用户“看到旧文案”,绝大多数是包没下发/没下载完,先别改 CDN 缓存。
3.5 坑点清单:前端改动和容器包版本不对齐
离线包最经典的故障:旧 index 引用新 js。页面主文档来自 CDN(或回源已换新),但它引用的 hash 资源列表是旧包的——新首屏去请求一个最新 CDN 根本没有、或旧包已删的 js:
| 坑 | 现象 | 根因 | 解法 |
|---|---|---|---|
| 主文档新、子资源旧 | 局部白屏、接口功能异常 | index.html 走 CDN/新包,hash 资源列表与 CDN 不同步 | 主文档也进包(同源同 version 一起版本化),杜绝“一半新一半旧” |
| hash 资源在 CDN 上被清了 | 新包引用的 js 404 | 旧文件被清理策略误杀,而包内仍在引用 | 文件名带 hash + 保证 hash 资源有足够保留期(不可变、可清理但要有生命周期) |
| 包只下发了主文档没下子资源 | 命中后资源全挂 | 清单与文件集合不一致 | 带文件名hash 的健全做法:清单里记每个文件的内容 hash,下载/合成后整体校验,不匹配就当包损坏回源 |
| 前端改动走 CDN 而不进包线 | 线上 Web 新版、离线包用户永远旧 | 漏打包线 | 双发布线 CI 合并,打不了包就当发版失败 |
给前端的健全做法:构建产物文件名一律带内容 hash(app.83f2a1.js),做到两点——① 资源不可变:一个 URL 永远对应同一份字节,Cache-Control 敢给一年;② 版本可对账:CDN 上有什么、包里有什么,都能按 hash 精确核对。绝对不要在 hash 文件名上复用同名覆盖,那是 404 与强缓存错乱的高发区。
3.6 自测题
- 前端改了代码但没触发打包线,用离线包的用户会看到新版吗?为什么这个“看不见”很难查?
- 强更和弱更在“检测到新版本后做什么”上的本质差异是什么?各适用什么场景?
- 三个灰度道具各自控制什么维度?能组合使用吗?
- “主文档走 CDN、子资源走包”为什么是风险结构?文件带 hash 的健全做法还只是存下来,风险点在哪儿?
- 动手:模拟一个“旧 index 引用新 js”的 demo(1 份测试包 + CDN 资源对不上),然后用第 4 节的对账表把它归因出来。
参考答案(思考后再点开)
- 不会。离线包独立版本线,只发 CDN 不动打包线,用户包内仍是旧 bundle;因为“看得见新 CDN、看不见本地包”,“旧版现象”极易被误判为缓存,需要用
bundle_version对账。 - 强更:检测到即拉新、本地包立即切换;弱更:静默后台下载、下次进入才生效。破坏性变更→强更,日常迭代→弱更。
- 分别控制用户(UID)、客户端版本、运行环境;可叠加(如先环境→再版本→再 UID 放量)。
- index 与子资源走了两套发布时机,CDN 更新了 index 但包里/旧首屏还在引用旧 hash 资源,出现“一半新一半旧”。带 hash 只是让资源不可变、可对账,仍需保证清单文件表与 CDN 资源保留期一致,并用完整性校验避免半包。
- 归因链:看
bundle_version发现包还是旧版 → 比对资源 hash 发现引用了最新 CDN 已在清理期删除的 js → 判定为“主文档与子资源相同时序不一致”,修法是把主文档与子资源放进同一包版本并做整体 hash 校验。
4 · 预热池与容器公共能力:壳给了前端什么,为什么不是浏览器给的
4.1 问题引入
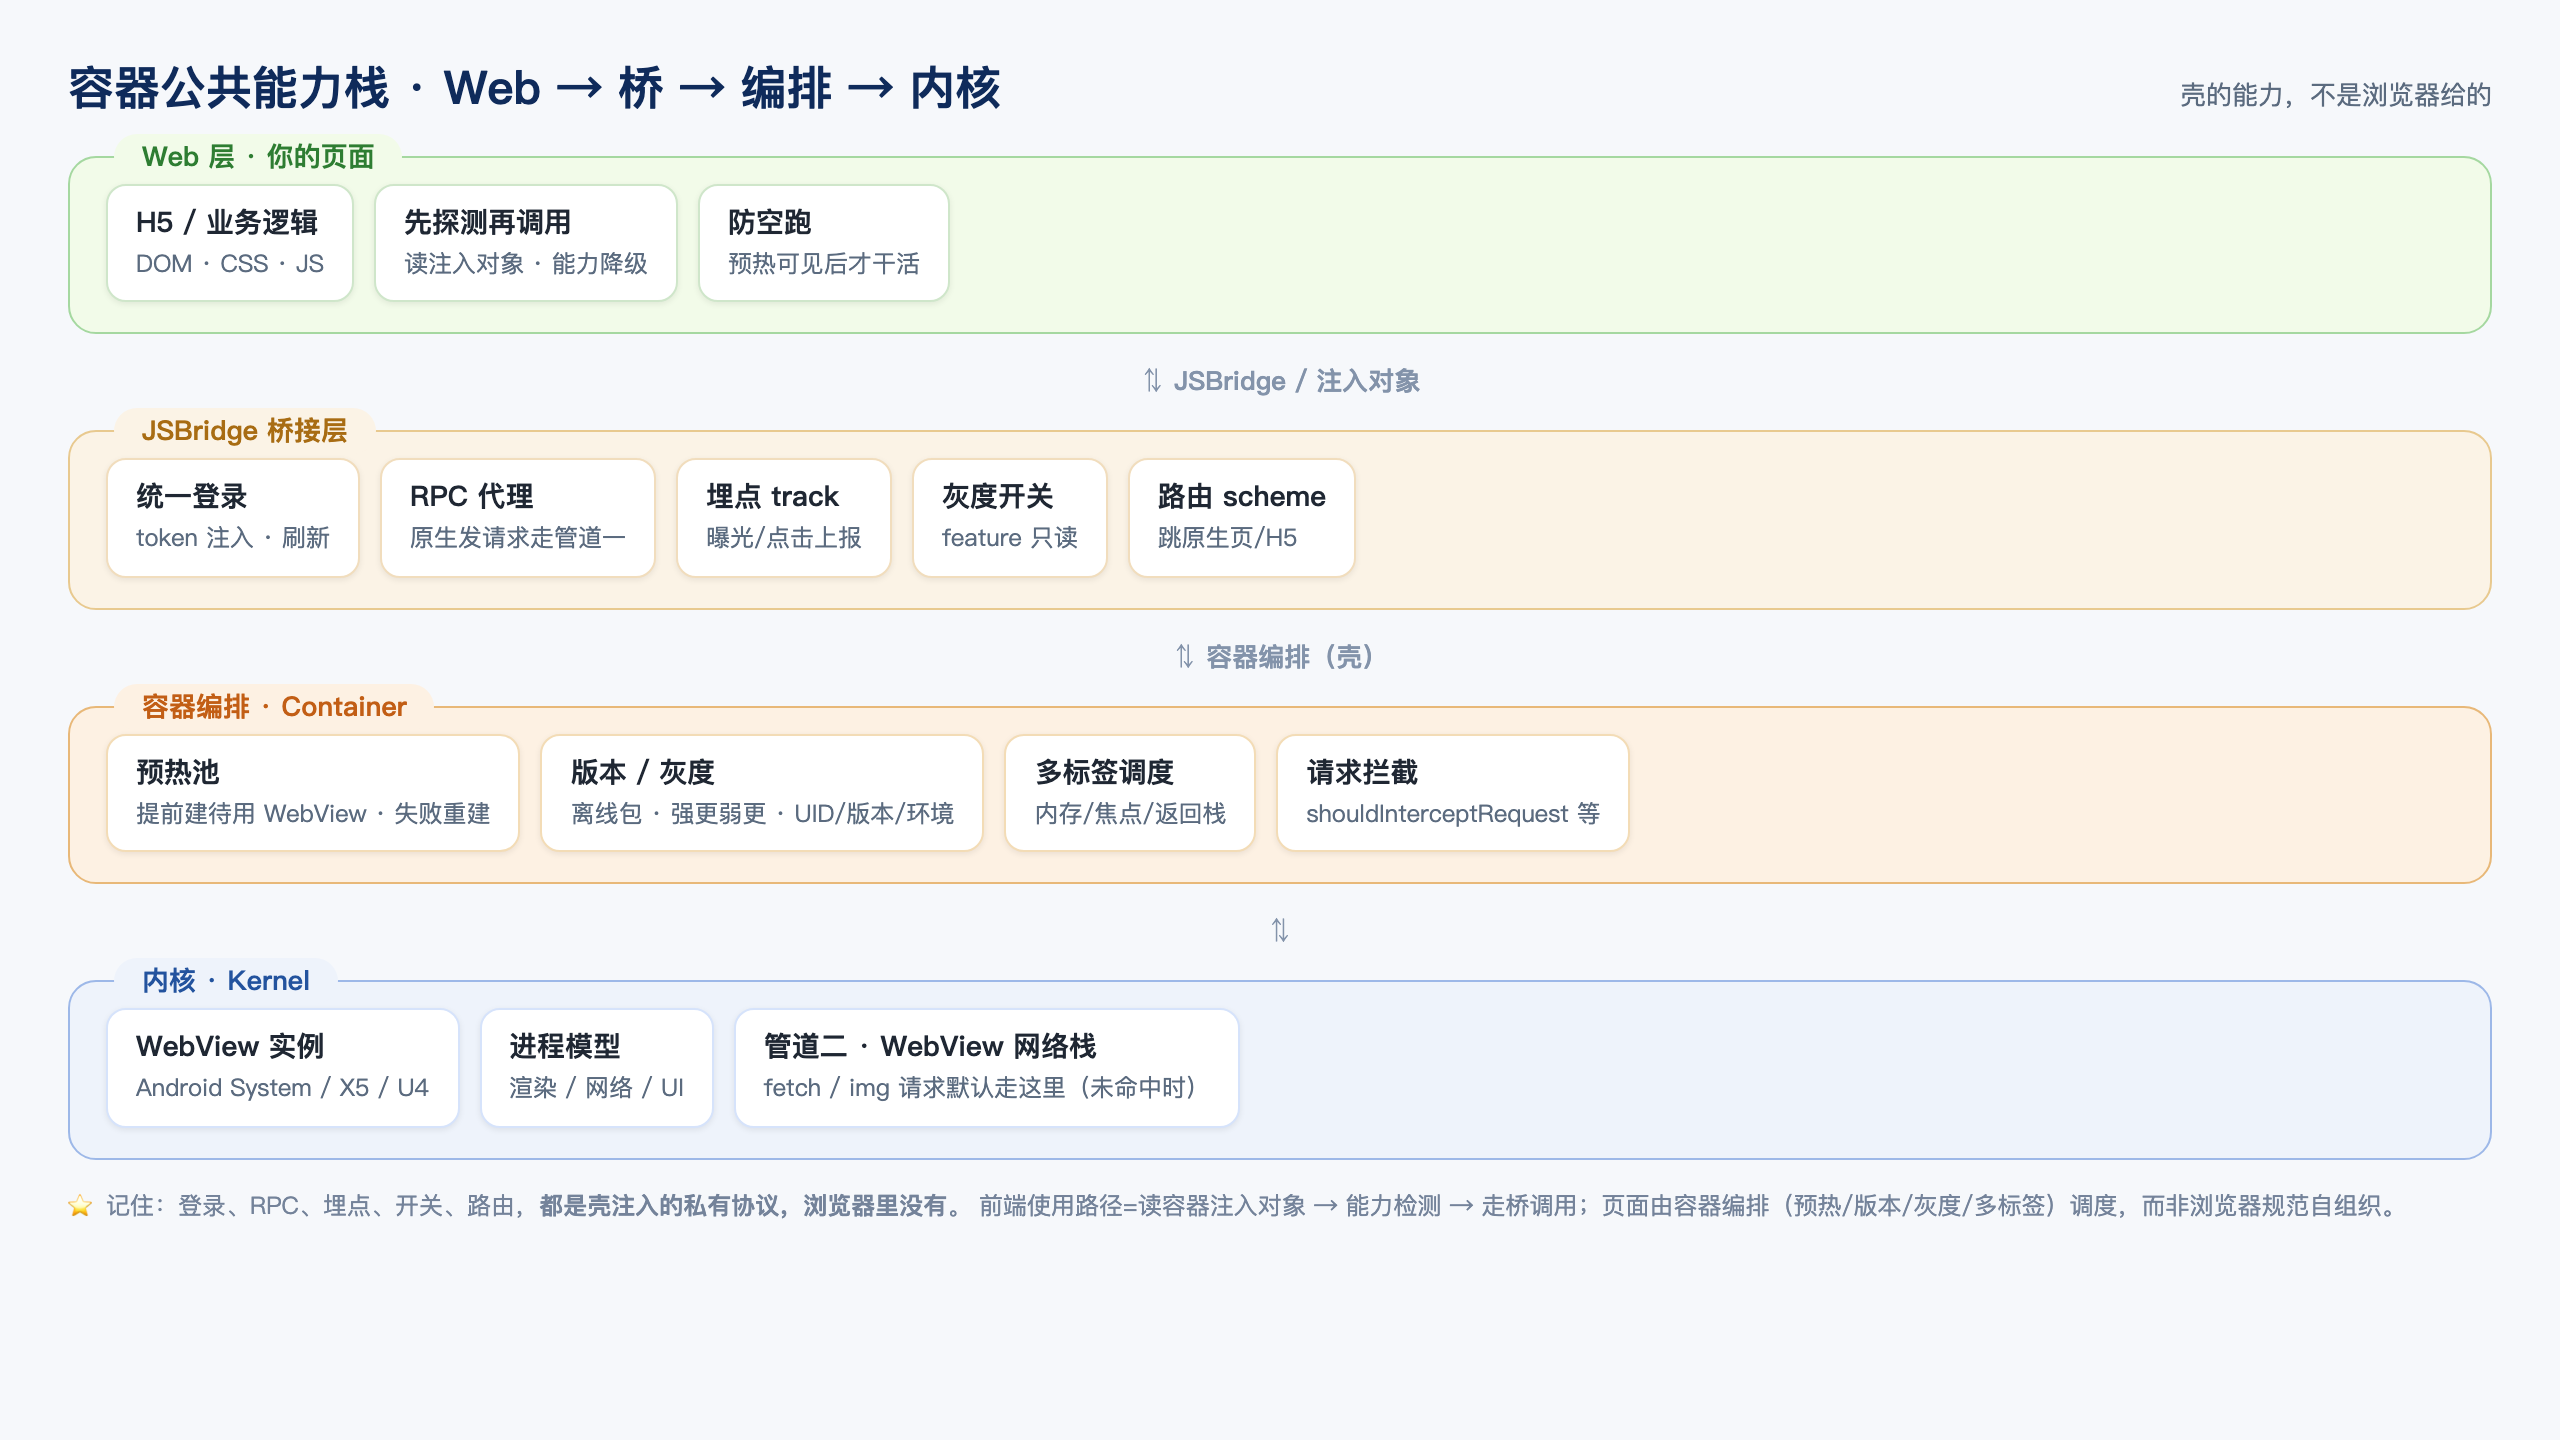
用户在 App 的首页底部 tab 上左右滑动,进入某个 H5 页,页面“秒开”;另一个 H5 第一次冷启动却要等内核进程起来。更奇怪的是,某个页面打开时你明明没调用任何接口,窗口期的日志里却有一串数据请求在飞。这些都不是前端代码做的——是壳在你没看见的地方干活:预热、预加载、数据预取。
同时,你的 H5 偶尔能读到 window.container.token、能调 bridge.rpc(),这些能力在浏览器里根本不存在。它们到底是谁注入的?为什么“浏览器里没有”?
4.2 先破误区
• 误区 一:“预热 = 提前把页面 JS 跑一遍,等于预执行。” • 事实:预热 ≠ 预执行。预热池只是提前创建好一个空的、配置就绪的 WebView 内核实例(常驻内存待用),并没有 load 你的页面。等真正打开时,从池里直接取出空壳 WebView、再 loadUrl,省掉的是“创建内核 + 初始化”这段最贵的耗时——而页面 JS 一个没提前跑。若容器在取出后、用户真正进入前提前 load 了页面(预加载),那才是预执行,二者要分清。
• 误区 二:“容器公共能力(登录、RPC、埋点、开关)是浏览器规范的一部分,页面天然该有。” • 事实:这些全是壳注入的、浏览器里根本没有。打开手机的 Safari/Chrome 复现这些对象,
undefined。它们是容器私有协议,由壳在页面加载前注入进 WebView 的 JS 运行时。
4.3 原理讲解一:预热池 / 预渲染的本质
4.3.1 预热池(WebView 池)
容器最贵的开销是创建 WebView 内核实例(内核进程、渲染进程、初始化配置)。预热池的账是这样算的:
- 冷启动时容器提前创建 N 个待用 WebView,配置好(JSBridge、UA、Cookie、离线包映射都已就绪),挂在池里;
- 用户点开 H5,容器从池里取出一个 → 直接
loadUrl,省掉创建与初始化那段最耗时阶段; - 白名单页可预创建更多、更早;普通页面随用随取;
- 失败回收:取出的 WebView 若崩溃/被系统回收(进程被杀),容器失败重建一个新实例顶上,不阻塞用户。
对前端意味着什么:页面被预热时,你的生命周期钩子可能完全不按浏览器惯例执行——容器可能在冷启动阶段就 pre-create 甚至提前 load 某些页面(预渲染/数据预取),JS 可能在用户根本没看到这页时就已经跑了。前端必须写防空跑代码,惯用法是“显示可见才真正干活”:
// 平台:前端 JS
// 用途:H5 出现前不要跑重活(防预热/预加载提前执行),页面真正可见才初始化
let done = false
const runHeavy = () => {
  if (done) return                      // 防重复初始化(预加载 + 真实打开各触发一次)
  done = true
  initChart()
  startPvReport()
}
if (document.visibilityState === "visible") {
  runHeavy()
} else {
  document.addEventListener("visibilitychange", () => {
    if (document.visibilityState === "visible") runHeavy()
  },
  { once: true })
}
4.3.2 冷启动优化:首屏模板预渲染 + 数据预取
- 首屏 HTML 模板预渲染:容器把首屏的 HTML(甚至已渲染好的骨架/结果片段)先塞进 WebView,页面一进来就有内容,再走异步补齐数据——时间线前移,“看起来秒开”。
- 数据预取:容器(常配合预热)在页面 load 前就通过客户端网络库把接口数据拉好、注入(
window.__PRELOAD__之类),页面 JS 启动时直接消费,省去首屏接口往返。
第一次遇到要先确认你的容器开没开这些;没开时“秒开”就是纯前端优化,布局和排查方向完全不同。
4.4 原理讲解二:容器公共能力清单
| 能力 | 壳做了什么 | 前端怎么用 |
|---|---|---|
| 统一登录 | 登录态/ token 由原生维护,注入到页(window.container.token)或运行时刷新 |
页内取注入对象拿 token,过期时调桥刷新,别自己存 localStorage 过期凭据 |
| RPC 代理 | 页面的业务接口走 bridge.rpc() 由 原生发请求(走管道一),享受签名/HTTPDNS/网关 |
API 调用收敛到 RPC 桥,享受客户端网络能力、统一鉴权监控 |
| 埋点 | 壳注入统一的埋点能力(曝光/点击/日志上报后台) | 调 bridge.track(),数据进统一大盘,比自建统计更全 |
| 灰度开关 | 容器下发 feature 开关(window.container.features),前端只读 |
启动时读开关做特性分支,开关更新由壳刷新,前端无条件轮询 |
| 路由 scheme 表 | 壳维护 detail://、pay:// 等路由表,location.href = scheme 或桥跳转 |
遵守壳的路由约定跳原生页/其他 H5,别用 window.open |
| 公共 UA | 壳统一设置 WebView UA(品牌标识 + 端版本 + WebView 版本) | 别乱改 UA;后端按 UA 识别来源端,改了会影响服务端兼容 |
这些能力的共同点:它们不在 WebView 内核里,也不在浏览器规范里,壳要专门做“注入 + 兑现”。发现与使用路径通常是:壳在 loadUrl 前注入一段公共 JS(往 window 上挂 container/bridge 对象),页面通过读容器注入对象 —— 检测能力 → 走桥调用三步使用。
// 平台:前端 JS
// 用途:能力检测惯用法 —— 页面依赖桥能力,先探测再调用,不探测直接调会 Scope 报错
function hasBridge(feature) {           // container / bridge 由容器注入,浏览器里不存在
  return !!(window.container && window.container[feature])
}
if (hasBridge("token")) {
  const token = window.container.token
  fetchHeaders.Authorization = `Bearer ${token}`   // 用注入登录态走接口
}
if (hasBridge("track")) window.bridge.track({ page: "home" })
4.5 坑点清单
| 坑 | 现象 | 根因 | 解法 |
|---|---|---|---|
| 预热页 JS 提前跑 | 埋点多报、请求提前发、图表白费资源 | 容器 pre-load 了页面,生命周期未必等用户看到 | 按可见性兜底:visibilitychange 后再跑重活 |
| 预热池失败重建乱序 | 偶发“这次没复用池” | WebView 进程被杀触发失败重建 | 前端别依赖“必然复用”,幂等初始化 |
直接 bridge.xxx 调 |
控制台 “xxx is not a function” | 只读了注入对象,没做能力探测 | 探测 + 兜底;未注入时给降级 |
| 自己存 token 到 localStorage | 过期凭据乱发、跨端不同步 | 绕过了容器的 token 刷新/注入 | 用容器注入与刷新通道,别绕行 |
| 浏览器里能跑、容器里报错 | 依赖了浏览器特有 API | 容器/内核裁剪了能力 | 能力检测 + 真实容器回归 |
4.6 自测题
- “预热 = 提前把页面 JS 预执行” —— 对还是不对?预热池到底省的是什么?
- 为什么“页面被预热时生命周期钩子可能不按浏览器惯例执行”?前端该写什么惯用法兜底?
- 列出 3 个“浏览器里不存在、壳注入”的容器能力,并说明为什么不能在浏览器里直接复现。
- 容器做了首屏模板预渲染 + 数据预取,作为一个 H5 作者,你能在代码里察觉到哪些痕迹?
- 动手:在你们项目的容器里尝试预热一个页面、外加预加载,用
visibilitychange观察生命周期时机,写一段防空跑代码。
参考答案(思考后再点开)
- 不对,预热 ≠ 预执行。预热只是提前创建好预留的、配置就绪的 WebView 内核实例(常驻内存待用),页面 JS 一个没跑;真正 load 页面(甚至提前 load)才叫预加载/预执行。预热省的是“创建内核 + 初始化”这段开销。
- 容器可能在用户看不到页面时就 pre-create / 预加载页面,JS 会在可见性未知时执行。兜底惯用法:
visibilityState === "visible"才做重活,并用 once + 标记防止预加载与真实打开重复初始化。 - 统一登录(token 注入)、RPC 代理、灰度 feature 开关(也含埋点、路由 scheme)。都是壳在 load 前注入的自有协议对象,浏览器规范/内核都不提供,Safari/Chrome 里访问为
undefined。 - 痕迹:页面一可见就有内容而没等接口、
window.__PRELOAD__类注入对象存在、接口请求发生在首屏之前、日志里出现尚未看到的页面字段。 - 预热 → “池”,预加载 → “提前 load 页面代理”;观察
visibilitychange/document.hidden判断可见时点,用done标记 + visible 门槛做幂等初始化。
5 · 容器演进:单页 → 多标签 → 小程序式容器
5.1 问题引入
你的 H5 在 App 里,前一个页面还开着、下一个页面又顶上来,两个页面同时在屏幕上转——这跟浏览器“一个标签页一个文档”的心智对不上。再往深挖,某些 App 里的“小程序”页面,前端 JS 竟然有两个线程在跑,主线程拿到数据还得自己 setData 才上屏。浏览器里没有这些。它们都是容器这个壳自己演化出来的调度模型。
5.2 先破误区
• 误区:“容器就是”没有地址栏的浏览器“,标签页就是多开 WebView。“ • 事实:浏览器里多个标签页是自组织的(每个标签独立渲染引擎,谁也管不了谁,关一个不影响另一个);容器里的多个页面是由壳统一调度的(内存池管理、焦点分配、返回栈、回收策略都由容器决定,页面只是壳手里的棋子)。“容器不是浏览器”在演进到小程序式容器时达到极致:连页面本身的执行都被壳重新定义了。
5.3 原理讲解:三级演进
5.3.1 单页容器:一个 WebView 走天下的起点
早期容器里一个 Activity/ViewController 只持有一个 WebView,一次只展示一个页面。它的问题是:页面间跳转要靠 loadUrl 换文档——上一个页面被彻底丢弃,返回时重新加载,JS 状态全丢、每次白屏。前端感知 = “在浏览器里好像刷新了一样,每次进入都重跑一轮初始化”。
5.3.2 多标签容器:多个 WebView 并存,壳来调度
为了解决“返回丢状态”,容器引入多个 WebView,同时存在、共享一个壳:
| 维度 | 壳要处理的 | 对前端的意义 |
|---|---|---|
| 内存 | 多个 WebView 很吃内存与进程数,需要“可见≥活着、不可见≥可回收、必要时杀掉重建(失败重建)” | 你无法假设“离开这页,代码一定不会跑”;后台页可能被回收 |
| 焦点 | 同时只有一个是“活的”焦点页,键盘/输入/可见性以此为基准 | 看 visibilitychange/activeElement 判断是否真的是当前页 |
| 返回栈 | 壳维护一套自己的页面栈,返回键走壳的栈而不是页内 history | 返回键行为、location.href 前进后退与浏览器不同步 |
极端体现:页面由壳调度,而非标签页自组织。 前台页与后台页的内存优先级是壳定的;某个页被回收,前端只看到 pageshow/blur / 进程死亡,看不到“浏览器多标签”式的确定性。
5.3.3 小程序式容器:多 WebView + 双线程模型
走到小程序,壳把“调度”推到极致:同一逻辑页面,被拆成两份、跑在两处。
- 多 WebView 协作:用户能看到的是渲染 WebView(装着一个很薄的渲染层);真正执行业务逻辑的是逻辑线程(另一个 WKWebView 的 JS 上下文,或独立的 JS 引擎)。
- 双线程隔离:逻辑线程与渲染线程隔离,各自独立运行互不干扰;
- setData 机制(点到为止):JS 在逻辑线程里跑,改数据不能直接碰 DOM,而是把变更数据通过
setData({...})桥到渲染线程,由渲染层用这份数据更新视图。这套“数据驱动上屏”的机制,是双线程模型的交换媒介。
对前端这套模型的震撼是:你的业务 JS 根本不在“你看到的那张 WebView”里跑,它在另一个线程算好、把数据同步过来渲染。这已经不是“容器像浏览器”,而是壳把 Web 执行环境重构成了自己的产物。
5.3.4 趋势一句带过
再往后,各厂自研内核(X5→XWeb、U4、以及各类 H5 容器一体化方案)的动机之一,就是自研内核 = 更精细的资源控制——从网络栈、进程拆分到内存回收,都在往“壳能精确管理页面死活”的方向走,反过来进一步拉大“容器 ≠ 浏览器”的差距。
5.4 代码验证(前端视角):跨容器兼容清单
不写那一堆看不完的原生代码,对前端更该给的是“在不同容器里写代码该怎么问自己”的清单:
| 关注点 | 你要确认的容器契约 | 否则会踩 |
|---|---|---|
| window 上的桥 | window.container / window.bridge 叫什么、挂哪些方法 |
直接 bridge.xxx() 报 not a function,且浏览器里没有 |
| 路由 | 跳页用 location.href=scheme 还是桥方法? |
用 window.open 被吞 / 新页不是你想要的原生页 |
| 预加载钩子 | 容器有没有 pre-load、__PRELOAD__ 注入?生命周期走 visible 还是 load? |
JS 提前跑、埋点重复 |
| 返回键约定 | 返回走壳的栈,页内 history.back() 行为是否一致? |
返回键回退了不该回退的页面 |
一句话:写一个能同时在浏览器和多种容器里跑的页面,第一步不是写代码,是去拿这份容器契约。 没有契约就写“既能探测、又能降级”的代码(能力检测惯用法见 04 篇 §5.4)。
5.5 坑点清单
| 坑 | 现象 | 根因 | 解法 |
|---|---|---|---|
| 多 WebView 内存爆 | 后台页被壳回收、回到时白屏重载 | 多个 WebView 常驻内存,壳按策略回收 | 别把状态只留在 Memory,重载后要能自愈(参考 04 防空跑幂等初始化) |
| 返回键行为怪异 | 返回走了壳的栈,不是页面 history | 壳的返回栈独立于文档 history | 问清容器返回约定,别依赖 history |
| 双线程 setData 掉了数据 | 业务 JS 改了变量视图没动 | 逻辑/渲染线程隔离,直接改内存不触发上屏 | 走 setData / 状态通道,别绕过框架改 DOM |
| 页面重载丢 cookie 依赖 | 自愈重载后 token 失效 | 壳回收后重载,前端凭据丢失 | 用容器 token 注入/刷新通道(04 篇) |
5.6 自测题
- “多标签页是浏览器自组织、多 WebView 容器是壳调度” —— 这两者在内存、焦点、返回栈上各自意味着什么?
- 小程序式容器里“业务 JS 在哪跑”与“用户看到的 WebView 是哪个”是同一回事吗?setData 解决什么问题?
- 前端写一个要跨多种容器跑的页面,开写前最该做、且最容易被忽略的事是什么?
- 为什么说“自研内核 = 更精细的资源控制”和“容器不是浏览器”是同一个趋势的两面?
- 动手:用一个可切换预加载/多标签的容器,逐项走一遍第 4 节的兼容清单,识别你们容器把你坑过的地方。
参考答案(思考后再点开)
- 浏览器多标签由各自渲染引擎自组织、互不影响;多 WebView 容器由壳统一调度:内存优先级由壳定(不可见可回收/失败重建)、焦点页唯一决定了键盘/可见性、返回走壳自己维护的页面栈而非文档 history。
- 不是。业务 JS 在逻辑线程跑,看到的是渲染 WebView;双线程隔离让 JS 直接改内存不会影响视图,setData 把数据同步到渲染线程触发上屏。
- 拿到这份“容器契约”:window 桥上挂什么、路由跳转方式、是否有预加载钩子、返回键约定。没有契约就写“可探测 + 可降级”的代码。
- 自研内核让壳能精确控制网络栈/进程拆分/内存回收,都是为了“壳能决定页面怎么活”;越往这个方向走,页面越由壳调度而非浏览器规范自组织,两者是同一演进的同一面向。
- 逐项走一遍:window 桥对象名与能力、路由跳法、
visibilitychange时机、返回键行为;把被坑项记成“容器侧需修复 + 前端侧可试探性规避”两个清单。
5.7 小结
到这一篇,阶段 7 的离线包与容器化就闭环了:从“离线包的本质”(请求拦截映射)到“三种拦截实现”,再到“版本/更新/灰度”与“预热池/公共能力”,最后落到“容器演进的调度模型”。你应当能回答开头那个问题——为什么某些 App 的 H5 首页“看起来像原生一样快”,并且能归因:是离线包命中、预热池、数据预取,还是纯前端优化。下一阶段进入性能:把启动/白屏/渲染/内存逐个拆开归因。
本章术语表
| 术语 | 大白话解释 |
|---|---|
| 离线包 | 把 H5 静态资源提前打进 App 或按版本下到手机,请求发出去之前就被替换成读本地文件,首屏 0 网络往返。 |
| 请求侧拦截 | 离线包的工作位置:在资源请求出发前接管,和“响应回来后才存”的 HTTP 缓存方向正好相反。 |
| HTTP 缓存 | 靠 Cache-Control/ETag 等响应头、由内核在响应回来后存取的缓存,前提是第一次真的请求过。 |
| Service Worker | 页面注册的 JS 拦截脚本,在 fetch 事件里自己决定回什么;是 Web 层方案,iOS 上受策略约束能力受限。 |
| shouldInterceptRequest | Android 的资源拦截回调,每个资源请求都会来问一次宿主;返回本地响应算接管,返回 null 就回源。 |
| WebResourceResponse | 命中时手工组装的响应对象,mime、编码、本地文件流都要自己填;想表达“不接管”必须返回 null。 |
| 清单(manifest) | 记录包 ID、版本、URL 和包内文件对应关系的目录,拦截器靠它把一条 URL 映射到本地文件。 |
| 命中 | 请求 URL 在清单里找到了对应的包内文件,直接开本地文件流当响应交给内核。 |
| 回源 | 未命中时交还内核、让请求照常走网络的兜底路径,离线包必须保留它防止白屏。 |
| 主文档 | 页面的入口 HTML;它同样会走拦截回调,做 拦截时要一起接管。 |
| 数据预取 | 页面打开前容器先把接口数据拉好备着,省掉首屏接口往返(本节提及,04 篇展开)。 |
| 差量(bsdiff) | 只下发相对上一版的差异、在手机上合成完整包,省流量的分发方式。 |
| 分包 | 把包拆成主包和业务包:主包随 App 内置,业务包按需或预载下载。 |
| 0 网络往返 | 首屏静态资源全部来自本地磁盘,一个网络请求都不发,断网也能打开页面壳。 |
| WKURLSchemeHandler | iOS 的拦截入口,但只能接管自定义 scheme,给 http/https 等保留 scheme 注册会直接抛异常。 |
| 自定义 scheme | 自己起名的 URL 协议(如 x-offline://),把页面加载在它上面,请求就会交给壳的 handler。 |
| URLSchemeTask | iOS 里每个 scheme 请求对应的任务对象,靠 didReceive/didLoad/didFinish 把本地内容喂回内核。 |
| start/stop 生命周期 | task 被取消即触发 stop,之后再调 task 的任何回调会崩溃,必须登记并保证恰好 finish 一次。 |
| 本地 HTTP Server | 在 App 进程内起一个 127.0.0.1 端口的 HTTP 服务,把请求引到本地磁盘目录的历史方案。 |
| 回环地址 | 即 127.0.0.1;页面 URL 以它开头,往往是容器走过本地 server 路线留下的“活化石”。 |
| 明文限制 | Android 9+ 默认禁止非 HTTPS 明文流量,本地 server 要在 networkSecurityConfig 里放行 127.0.0.1。 |
| ATS 例外 | iOS 的网络安全策略,本地回环地址也要单独配例外才能走 http。 |
| 端口占用 | 本地 server 要独占一个端口,冲突时需探测重试,是方案 C 的固有成本之一。 |
| 子资源 | HTML 引用的 CSS/JS/图片等;自定义 scheme 页面里相对路径会解析成同 scheme 一起进 handler。 |
| referrer | 请求携带的来源页地址;主文档 URL 换成 scheme 或 127.0.0.1 后,它就不再是线上 https 地址。 |
| 埋点 | 前端数据上报,常携带页面 URL,URL 平面一换就可能取到异常域名,切换方案后要重新核对。 |
| 打包线 | 前端发布时除了线上 CDN,把构建产物打成离线包 bundle 的第二条发布链路,漏了它离线包用户永远拿旧版。 |
| 全量包 | 整个 bundle 一份 zip,随 App 内置或首次整包下载,用于新装和大版本。 |
| 差量包(bsdiff) | 只下载相对上一版的差异部分、在本地合成完整包,省流量省时间。 |
| 强更 | 检测到新版本直接拉新并切换、不给旧包机会,用于不更会出事的破坏性变更。 |
| 弱更 | 后台静默下载新版本、下次进页面才生效,日常迭代不打断用户。 |
| 灰度 | 新包不一次性全放,按用户(UID)、客户端版本、运行环境三个维度分批放量,可叠加使用。 |
| bundle_version | 离线包在 manifest 里的版本号,排查“用户拿到哪个版本”时第一个要对的账。 |
| 哈希命名 | 构建产物文件名带内容 hash(如 app.83f2a1.js),一个 URL 永远对应同一份字节,可强缓存、可对账。 |
| 回源兜底 | 包没下发、半包或文件缺失时退回 CDN/网络拿资源,保证页面不白屏的保底路径。 |
| 对账表 | 排查版本问题时逐项登记发布时间、发布物、用户端命中版本,定位“旧文案”卡在哪一环的模板。 |
| 预热池 | 容器提前创建好一批配置就绪的空 WebView 挂在内存里,用时直接取走,省掉“创建内核+初始化”这段最贵耗时。 |
| 冷启动 | 内核进程第一次起、一切从零开始的启动路径,预热池优化的正是这一段。 |
| 预加载/预执行 | 容器在用户真正进入前提前 load 页面,JS 会提前跑;和“只备空壳”的预热是两回事。 |
| 预渲染 | 容器把首屏 HTML(甚至已渲染好的片段)先塞进 WebView,用户一进来就有内容。 |
| 统一登录 | 登录态 token 由壳维护并注入页面(window.container.token),前端别自己往 localStorage 存过期凭据。 |
| RPC 代理 | 页面业务接口走 bridge.rpc() 由原生代发请求,享受签名、HTTPDNS、网关等客户端网络能力。 |
| 灰度开关 | 壳下发的 feature 开关(window.container.features),前端只读,启动时读来做特性分支。 |
| 路由 scheme 表 | 壳维护的 detail://、pay:// 等跳转约定,跳原生页/其他 H5 用 scheme 或桥,别用 window.open。 |
| 公共 UA | 壳统一设置的 WebView UA(品牌标识+端版本+WebView 版本),后端按它识别来源端,前端别乱改。 |
| 注入 | 壳在 loadUrl 前往页面挂 container/bridge 等对象;这些能力是容器私有的,浏览器里根本没有。 |
| 能力检测 | 调桥前先探测方法和对象存不存在,不存在就降级,避免直接 bridge.xxx 报 not a function。 |
| 防空跑 | 页面真正可见才执行重活:用 visibilitychange + 标记做幂等初始化,防止预热/预加载让 JS 白跑。 |
| 壳(容器) | 包在 WebView 外面的原生层,管页面生死、注入能力、维护离线包和路由,不是“没地址栏的浏览器”。 |
| 单页容器 | 一个原生页面只持有一个 WebView,跳转靠 loadUrl 换文档,返回就重载、JS 状态全丢。 |
| 多标签容器 | 多个 WebView 同时存活并存,由壳统一调度内存、焦点和返回栈,解决返回丢状态的问题。 |
| 小程序式容器 | 渲染和逻辑拆开、双线程协作的容器形态,壳连页面本身的执行模型都重定义了。 |
| 壳调度 | 页面的内存优先级、焦点、回收重建都由容器决定,而不是像浏览器标签页那样自组织。 |
| 双线程 | 业务 JS 跑在逻辑线程、用户看到的是渲染线程,两个线程隔离运行、互不干扰。 |
| 逻辑线程 | 真正执行业务 JS 的地方,通常是另一个 WebView 的 JS 上下文或独立 JS 引擎。 |
| 渲染 WebView | 用户看得到的那层薄渲染层,只负责拿数据画界面,不跑业务逻辑。 |
| setData | 逻辑线程把数据变更桥接到渲染线程的同步机制,数据改完要 setData 才会上屏。 |
| 返回栈 | 壳自己维护的页面栈,返回键走它而不是页面 history,返回行为与浏览器不同步。 |
| 失败重建 | WebView 崩溃或进程被杀后,容器再造一个新实例顶上;前端状态会丢,要能自愈。 |
| 自研内核 | X5→XWeb、U4 这类厂商自制内核,目标是更精细地控制进程、网络栈和内存回收。 |
| 容器契约 | 跨容器开发前先拿到的约定清单:window 桥叫什么、路由怎么跳、有无预加载、返回键约定。 |
评论